
搜索引擎看到的和用户看到的必须一致:目录站的 cloaking 红线在哪
 搜
有个目录站站长问我:我在移动端把用户引导到小程序,桌面端显示网页,这算不算作弊?这个问题没有一句话的答案,但谷歌的政策文件里,边界其实写得挺清楚。
图片来源:网络,版权归原作者所有,侵权请联系删除
官方定义只有两句话
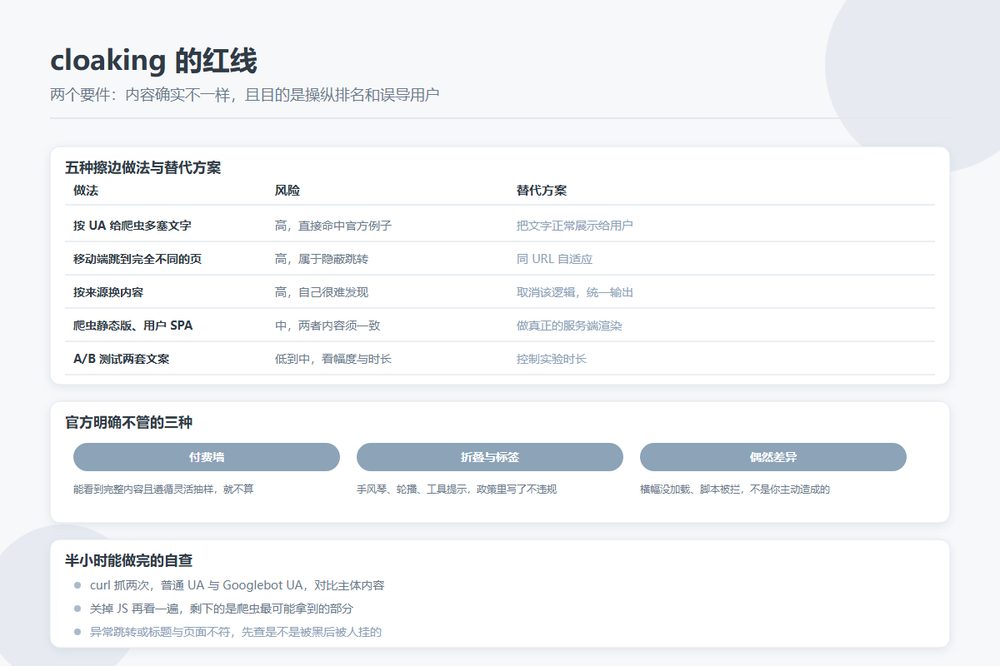
谷歌《适用于 Google 网页搜索的垃圾内容政策》里,伪装真实内容(cloaking)指的是为了操纵搜索排名并误导用户,向用户和搜索引擎分别呈现不同内容。文件给了两个例子:向搜索引擎显示旅行目的地页面、向用户显示折扣药品页面;以及仅当请求方是搜索引擎时才插入文字或关键词。
注意定义里有两个要件:一是内容确实不一样,二是目的为操纵排名和误导用户。缺少第二个要件,很多看着像 cloaking 的情况其实不算。
官方明确不管的三种情况
- 付费墙。如果搜索引擎能像任何有权限的用户那样看到付费墙后的完整内容,并且遵循灵活抽样的指引,就不算伪装。
- 折叠与标签内容。手风琴、标签页、轮播、工具提示这类为改善体验而隐藏内容的组件,政策里明确写了不构成违规。
- 技术差异导致的偶然不同。Cookie 横幅没加载、脚本被拦截、渲染延迟,这类差异不是你主动造成的。
第三点要小心:如果你明知道爬虫渲染不出主体内容,还把内容全部放在脚本里,那就不是偶然了。
目录站上常见的六种擦边做法
| 做法 | 风险 | 替代方案 |
|---|---|---|
| 按 UA 给爬虫多输出文字 | 高,直接命中官方例子 | 把这些文字正常展示给用户 |
| 移动端跳到完全不同的页面 | 高,属于隐蔽跳转 | 同 URL 自适应,或规范的移动映射 |
| 按来源(Referer)换内容 | 高,且你自己很难发现 | 取消该逻辑,统一输出 |
| 给爬虫返回静态版,给用户 SPA | 中,两者内容必须一致 | 做真正的服务端渲染 |
| 未登录用户看不到条目 | 中,等于爬虫什么都抓不到 | 基础信息公开,深度功能再登录 |
| A/B 测试两套文案 | 低到中,看差异幅度与时长 | 控制实验时长,别长期分叉 |
按来源换内容这条在目录站上出现过:站主想让从搜索进来的人看到更详细的介绍,于是判断来源。结果是他自己用浏览器直接访问,看到的一直是简版,压根不知道有问题。
怎么自查
三个动作,半小时能做完。
- 用
curl把同一页面抓两次,一次用普通浏览器 UA,一次用 Googlebot 的 UA,对比主体内容的差异。 - 在 Search Console 的网址检查里看「已抓取的页面」,检查渲染后的 HTML 里有没有正文。
- 把 JS 关掉再访问一遍,看页面还剩多少内容。剩下的是爬虫最可能拿到的部分。
第一个动作有个前提:光改 UA 不能伪装成真实爬虫,真实爬虫会过反向 DNS 验证。反过来也意味着,如果你的程序按 IP 段判断,伪造 UA 的测试方法可能测不出问题,这时要看代码逻辑本身。
还有一种 cloaking 你不是主动做的:站点被黑之后,攻击者常会针对爬虫和真人返回不同内容,让站主难以察觉。站点出现异常跳转或搜索结果里的标题与页面不符时,先往这个方向查。
判断标准很简单:如果一个普通用户关掉 JS、换台设备、不从搜索点进来,看到的还是不是同一份内容。是,就安全;不是,就要改。
目录站因为条目多、模板多,很容易在某个模板里留下一个只在爬虫侧生效的分支。做个季度检查,把几个主要模板类型各抽一页跑一遍上面的三个动作,比事后补救省事得多。