
无限滚动、日历页、会话 ID:目录站里三种越爬越多的陷阱
 无
一个两万个条目的目录站,被搜索引擎抓了十几万次,日志里绝大多数请求落在几千个看起来差不多、内容也差不多的 URL 上。这不是页面多,这是掉进了爬虫陷阱:站点自己能生成无限多的地址,每个地址返回的内容又高度重复,于是抓取预算全花在了这些地址上,真正重要的页面反而排不上号。
图片来源:网络,版权归原作者所有,侵权请联系删除
陷阱一:无限滚动但没有分页链接
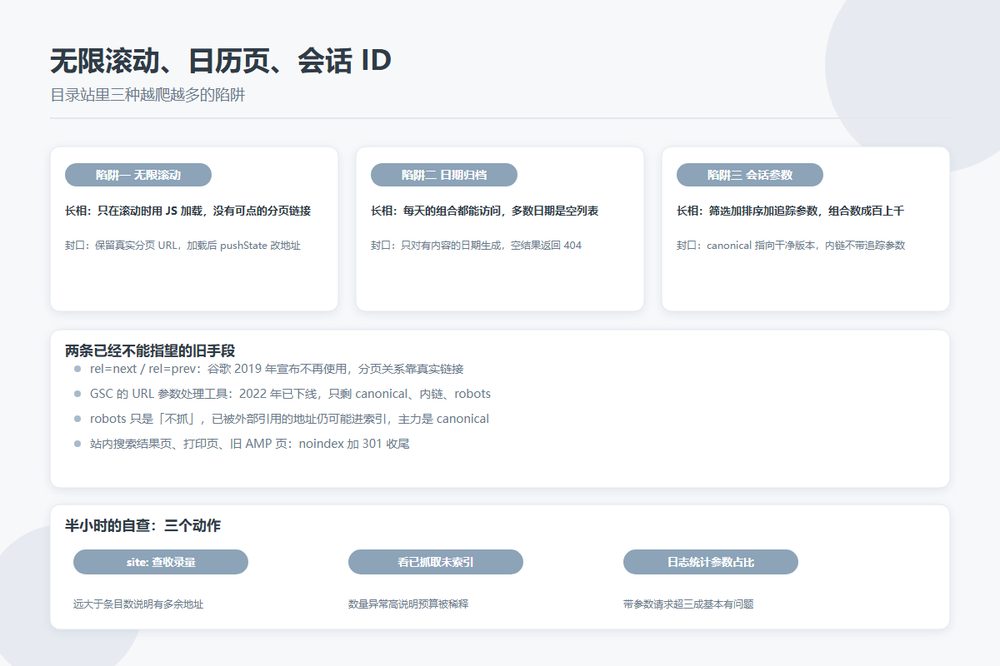
无限滚动在目录站上很常见,体验也确实顺滑,滚到底自动加载下一批。问题是如果这些内容只在滚动时通过 JS 加载,页面上没有任何可以点的分页链接,那么爬虫只能看到第一屏那几十条,后面的条目等于不存在。
正确的做法是保留真实的分页 URL。列表底部要有能点击的页码或者「加载更多」按钮,按钮背后是 <a href="/cate/design?page=2"> 这样的真实链接,滚动加载可以用 JS 增强,但基础必须是可抓取的链接。加载完顺手用 history.pushState 把地址改掉,用户刷新还在同一位置,爬虫也能顺着往下走。
这里补一句:rel="next" 和 rel="prev" 谷歌 2019 年就宣布不再使用了,别再指望靠它告诉搜索引擎分页关系,现在靠的就是真实链接和内部链接结构。
陷阱二:按日期归档
带日期属性的目录站容易踩这个坑。按「年/月/日」生成归档页,理论上每一天的组合都能访问,其中大部分日期没有任何条目,返回的是空列表或者一句「暂无内容」。这些空页数量是无限的,而且千篇一律,属于典型的低质量页面集群。
封口办法有三个,按顺序做:只对有内容的日期生成页面;空结果直接返回 404,而不是返回一个空壳页面;归档层级不要太深,做到「年/月」两层就够了,日级归档除非内容量真的撑得住,否则别开。
陷阱三:会话 ID 和参数组合
这一类的杀伤力最大,因为它的组合是真的会爆炸。假设有 5 个筛选项、3 种排序方式,每个都有独立参数,那组合数就是几十种;再加上 ?sid= 这种会话参数、?utm_source= 这类追踪参数,一个列表页能变出成百上千个地址。
处理办法:规范版本的 canonical 一定要写全,指向不带多余参数的主版本;内部链接一律用干净地址,别在导航里带追踪参数;会话 ID 尽量用 Cookie 而不是拼在 URL 上。robots.txt 里可以用通配符屏蔽明显的参数路径,但要注意这个文件只是「不抓」,被屏蔽的地址如果已经被外部引用,仍然可能出现在索引里,所以 canonical 才是主力手段。
顺带说一句:谷歌 Search Console 里那个 URL 参数处理工具早在 2022 年就下线了,别再找它了,现在能依靠的只有 canonical、内部链接和 robots 这三样。
还有两个小的
站内搜索结果页是老问题,最好用 noindex 加 robots 拦掉,别让它参与索引。打印页和早年做过的 AMP 页也容易留下大量重复地址,改版时顺手清理,用 301 指向主版本。
怎么自查
三个动作,半小时能做完。第一,在各搜索引擎用 site: 查收录量,如果远远大于你实际的条目数,说明有多余地址被索引了。第二,看 Search Console 的页面索引报告,「已抓取但未索引」这一类的数量如果异常高,往往是重复地址太多导致抓取预算被稀释。第三,翻服务器日志,按 URL 里的参数做统计,看看带参数的请求占总抓取量的比例,超过三成基本就有问题了。
查出来之后别一次性全砍,先按参数分组,从量最大的那一组开始处理,处理完观察两周再看下一组。目录站的 URL 结构牵一发动全身,慢一点比较稳。