
筛选页和排序页要不要收录:目录站分面导航的四类处理
 筛
目录站做大了都绕不开这个问题:站点数过千之后,光靠分类不够用,用户想按语言、按平台、按收费方式筛。筛选一做,URL 就爆炸——每个组合一个地址,蜘蛛一头扎进去,抓取预算全喂了参数页。筛选页和排序页到底怎么处理,这篇给一套可以直接抄的决策框架。
图片来源:网络,版权归原作者所有,侵权请联系删除
先问一个问题:有人搜这个组合吗
所有筛选页的收录决策,起点都是这一个问题。"免费的设计工具""中文的 AI 写作工具"——这种有真实搜索需求的组合,值得做成能排名的落地页。"免费+中文+AI+协作+2026"这种四五层条件的叠加,没人会这么搜,做出来就是薄内容。
想清楚了这个问题,四个处理方式各归各位。
四类处理,一条一条对
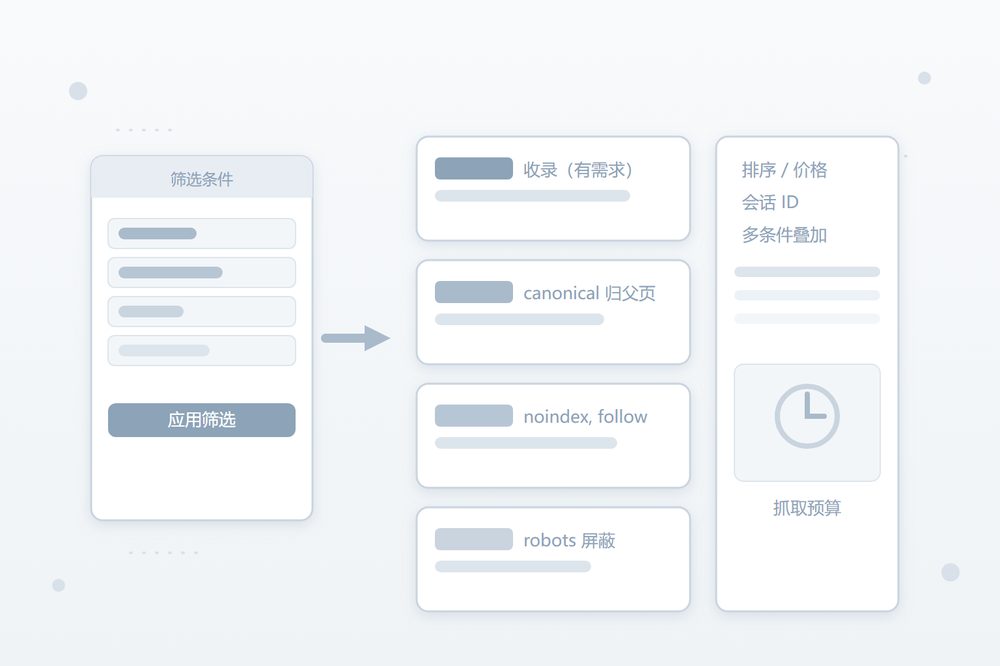
| 页面类型 | 处理方式 | 原因 |
|---|---|---|
| 有搜索需求的筛选组合 | 收录,配独立标题和介绍文案 | 这就是个落地页,按正经页面做 |
| 排序页(按价格、按时间) | canonical 指向父分类或 robots 屏蔽 | 排序只改顺序不改内容,没有独立价值 |
| 无需求的单条件筛选 | noindex, follow | 页面可以抓,链接照常传递,但不进索引 |
| 多条件叠加、会话参数 | robots.txt 屏蔽 | 纯组合爆炸,抓都不值得抓 |
谷歌官方的分页文档里也是这个口径:排序产生的 URL 用 noindex 或 robots.txt 处理,别让同内容的不同顺序进索引。
三个容易踩的组合错误
一,robots 屏蔽和 noindex 同时上。robots.txt 屏蔽之后蜘蛛根本不来抓页面,meta 里的 noindex 它看不见。正确顺序是先 noindex,等索引里清干净了,再考虑加 robots 屏蔽省抓取预算。
二,筛选页全部 canonical 到父分类。canonical 是个提示不是指令,谷歌经常无视它。对真正有需求、内容差异明显的筛选页,canonical 反而把能排名的页面主动按掉了。有需求的收录,没需求的才归一,别一刀切。
三,用 JS 前端筛选却留下 URL。最干净的方案是低价值筛选纯前端实现,不产生新 URL。点了筛选,列表在浏览器里重排,地址栏不变,蜘蛛无感。这个做起来最省心,用户体验也不差。
目录站自己的小优势
目录站比电商站好办:条目总数可控,筛选维度少。电商一个 SKU 几十个属性,目录站的筛选维度撑死十来个。建议花一个下午把所有筛选参数列个表,逐个标注"收录/归一/不索引/屏蔽",写进程序配置里。这张表就是你的分面导航策略,以后加新筛选项就往表里添一行。
定期复查一下 Search Console 的索引覆盖报告,参数页的数量是不是在涨。涨了说明哪条规则漏了,回头补上就行。筛选功能对目录站是加分项,前提是你告诉搜索引擎哪些组合值得看、哪些不值得。