
ETag、Last-Modified 和 max-age:目录站省下抓取预算的三个响应头
 E
一个有几万条目页的目录站,内容真正变化的可能每天只有几十条。但如果不做缓存协商,搜索引擎每次回访都是一次完整下载,几万个页面轮一遍,服务器负担和抓取配额都被吃掉。
HTTP 标准里早就为这件事准备了机制,谷歌的抓取基础设施也支持。只是很多 CMS 默认没开,或者开了一半。
图片来源:网络,版权归原作者所有,侵权请联系删除
谷歌官方支持哪几种
谷歌在抓取工具文档里写得很清楚:抓取基础设施支持 HTTP 缓存标准定义的启发式缓存,具体通过两对头实现。
| 响应头 | 配对的请求头 | 作用 |
|---|---|---|
| ETag | If-None-Match | 用内容标识符判断是否变更 |
| Last-Modified | If-Modified-Since | 用时间判断是否变更 |
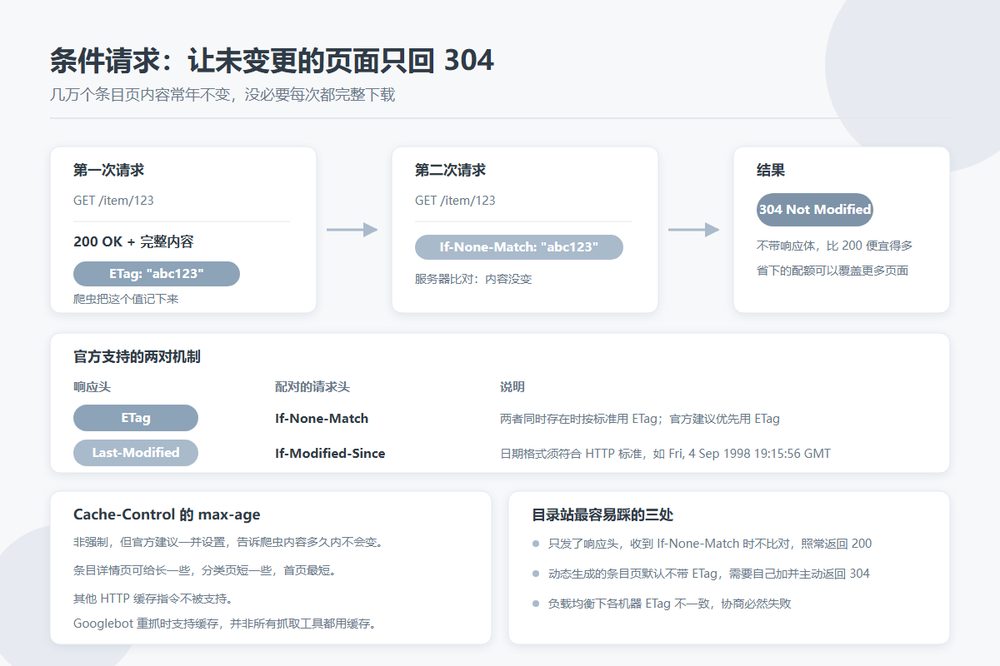
流程是这样:爬虫第一次抓页面,记下服务器返回的 ETag 值;下次来的时候带上 If-None-Match: 那个值;服务器比对,没变就返回 304 Not Modified,不带响应体。304 的响应比 200 便宜得多。
两个头同时存在时,按 HTTP 标准爬虫会使用 ETag。谷歌也明确建议优先用 ETag 而不是 Last-Modified,理由是 ETag 不存在日期格式解析的问题。
怎么配
ETag
大多数 Web 服务器默认就会给静态文件发 ETag,通常是文件大小和修改时间的组合。问题出在动态页面上:目录站的条目页如果是 PHP、Node 之类动态生成的,默认不带 ETag,需要自己加。
最简单的做法是对渲染结果算一个哈希当 ETag 值。条目数据没变,哈希就不变,返回 304。要在应用里自己判断 If-None-Match 并主动返回 304,否则等于只发了头没用上。
Last-Modified
日期格式必须符合 HTTP 标准,官方建议用这种写法:
Last-Modified: Fri, 4 Sep 1998 19:15:56 GMT注意是「星期几, DD Mon YYYY HH:MM:SS 时区」,月份是三字母英文缩写,时区写 GMT。格式写错就白配了。
Cache-Control 的 max-age
这一条不是强制的,但谷歌建议一并设置,用它告诉爬虫「这个内容大概多久内不会变」,单位是秒。设置成你预计内容保持不变的秒数。
目录站可以分级设:条目详情页内容稳定,给长一点,比如一周;分类页因为会随新增条目变化,给短一点,比如几小时;首页和热门页最短。
几个容易搞错的地方
只发头不处理请求头:服务器返回了 ETag,但收到 If-None-Match 时不做比对、照常返回 200 和完整内容,等于没配。这个要实测。
用了其他缓存指令:谷歌明确说只支持上面这两对机制,其他 HTTP 缓存指令不被支持。指望用 Cache-Control 的其他字段去控制抓取频率,没用。
不是所有爬虫都用缓存:各个抓取工具是否使用缓存,取决于它们所属产品的需求。Googlebot 在为搜索重新抓取时支持缓存,Storebot-Google 只在特定条件下支持。所以别指望 304 能把所有抓取请求都变便宜。
ETag 在负载均衡下不一致:多台机器如果各自生成不同的 ETag(比如把 inode 算进去),同一页面在不同机器上值不同,缓存协商会失败。集群环境下要保证同一内容产出同一个 ETag。
怎么验证配好了
用 curl 走两步最直观。第一次请求看响应头里有没有 ETag 或 Last-Modified;第二次带上 If-None-Match 再请求,看返回是不是 304:
curl -I https://example.com/item/123
curl -I -H 'If-None-Match: "abc123"' https://example.com/item/123
第二条返回 304 Not Modified 就说明生效了。也可以在服务器日志里统计 Googlebot 请求里 304 的比例,这个数字比任何配置检查都实在。
省下来的抓取预算用在哪
未变更的页面返回 304 之后,同样的抓取配额可以覆盖更多页面,新条目和刚更新的分类页会被更快抓到。这才是配这几个头的真正目的,不是为了让服务器压力小一点那点收益。