
后台编辑器粘贴出来的脏 HTML:目录站的正文清洗规则该怎么定
 后
目录站的条目简介和分类页介绍,多数是编辑在后台富文本编辑器里写的。写得顺手,粘贴是常态——从官网介绍页复制、从 Word 文档复制、从另一个页面复制。
粘贴进来的 HTML 长这样:
<p class="MsoNormal" style="margin:0cm;text-align:justify;
   font-size:10.5pt;font-family:等线">
  <span style="color:#333"><font face="宋体">这是一段</font></span>
  <span lang="EN-US"><o:p></o:p></span>
</p>
内容只有「这是一段」四个字,标签有三层。这种东西进了正文库,后面所有的模板、样式、结构化数据都得跟着遭殃。
图片来源:网络,版权归原作者所有,侵权请联系删除
脏 HTML 具体带来什么问题
不是洁癖问题,是真有代价:
- 页面体积。一段 200 字的正文能带上 3KB 的内联样式。分类页上有几十条简介时,累积起来很可观。
- DOM 节点数。无意义的 span 和空段落会成倍放大节点数,直接影响渲染性能。Lighthouse 的 DOM 数量提醒(800 警告、1400 错误)很多时候就是这么堆出来的。
- 标题层级被打乱。从 Word 粘过来的「标题」往往不是 h2/h3,而是带样式的 p 标签,或者干脆是 h1。页面里多出几个 h1,语义层级就乱了。
- 样式覆盖。内联
style的优先级高于你的 CSS。编辑器带进来的字号、颜色、字体,会把你的正文样式顶掉,页面看起来一块一块不统一。 - 隐藏内容风险。有些粘贴内容里带着
display:none或者白色文字,你自己都不知道页面上藏着一堆看不见的字。这在内容质量评估里是最容易被误判成作弊的一类。
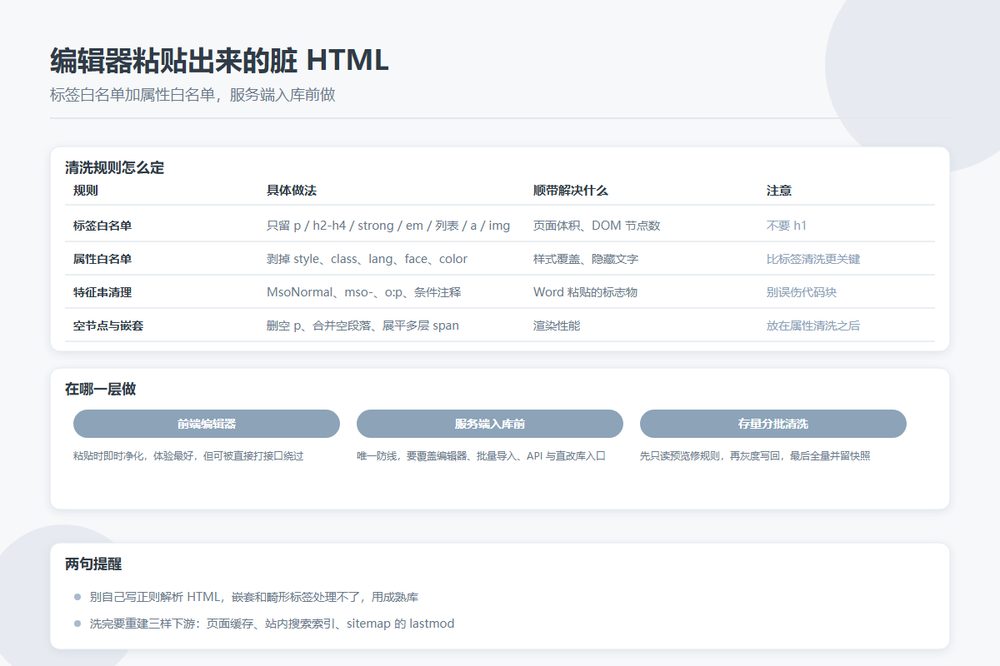
清洗规则怎么定
标签白名单
不要去列举禁止哪些标签,列允许哪些。目录站正文通常需要的是:
| 类别 | 允许 | 说明 |
|---|---|---|
| 结构 | p、br、h2、h3、h4 | 不要 h1,页面标题已经用掉了 |
| 强调 | strong、em | b 和 i 转成 strong / em |
| 列表 | ul、ol、li | 层级不要超过两层 |
| 链接 | a | 只保留 href,外链统一加 rel |
| 媒体 | img | 只保留 src、alt、width、height |
其他标签一律丢弃,标签内容保留。table 看情况,多数目录站正文用不到。
属性白名单
这一步比标签清洗更重要。style、class、lang、face、size、color、bgcolor 全部剥掉,只留上面表里列的那些功能属性。
顺带处理掉这些特征串:MsoNormal、mso- 开头的样式声明、<o:p>、xmlns:v、条件注释。这些都是 Word 的标志物。
空节点和冗余嵌套
清洗完之后再过一遍:删掉没有文本内容的 p、连续合并的空段落、嵌套三层的同类标签(span 套 span 套 span)。这一步要在属性清洗之后做,因为很多标签剥完属性之后就变成空壳了。
标题层级归一化
从 Word 粘来的标题识别不出来,但有个笨办法有效:如果页面上没有 h2,就把第一个带「标题样式」特征的段落提为 h2。更稳的做法是直接在编辑器里禁掉 Word 的标题样式导入,让编辑用编辑器的标题按钮重新点一遍。
在哪一层做清洗
答案是服务端,入库之前。
编辑器前端也可以做一次清洗——用户粘贴时立刻净化,编辑所见即所得,体验最好。但前端清洗可以被绕过(直接打 API、导入功能、批量导入脚本),所以它只是体验优化,不能作为唯一防线。
服务端这一层要覆盖所有入口:编辑器保存接口、批量导入、API 写入、数据库直接改。少了任何一个,脏数据迟早从那个口子进来。
如果是 PHP,可以用 HTML Purifier 这一类的成熟库;如果是 Node,sanitize-html 或者 DOMPurify(服务端跑)都行。别自己写正则去解析 HTML,正则处理不了嵌套和畸形标签,这是有共识的结论。
编辑器侧能做的几件事
- 默认「粘贴为纯文本」,需要保留格式的用「保留格式粘贴」按钮
- 标题按钮只有 h2/h3/h4,不给 h1
- 上传图片时强制填 alt,并自动写入真实宽高
- 保存前的字数统计按纯文本算,别把标签算进去
存量内容怎么洗
清洗规则定好了,库里几千条历史数据怎么办。直接跑一遍全量替换风险太大,我的做法是分三步:
- 先做只读预览。拿 200 条样本跑清洗,人工对比清洗前后的渲染结果,把误伤的规则挑出来修掉。常见的误伤包括:把必要的 class(比如某些组件的钩子)洗掉了、把代码块里的缩进吃掉了、把特殊字符实体重复编码了。
- 灰度写回。先洗一个分类,观察一周,看搜索表现和页面渲染有没有异常。
- 全量执行 + 留快照。洗之前把原始 HTML 存一份到备份表,出问题能回滚。
洗完之后要重建的下游有三样:页面缓存、站内搜索索引、sitemap 的 lastmod。别只改了数据库就以为完事了。
顺手做的两件小事
一是在清洗管道里加一条统计:每条正文清洗前后的 HTML 长度、被丢弃的标签数。这些数字能看出哪个编辑的粘贴习惯最糟糕,也能在系统出问题时快速定位。
二是把清洗规则写成一页文档,放在提交指南旁边。合作方和外包编辑看到规则,从源头少粘贴一点,比事后清洗省事得多。