
RSS 和 Atom 还没死:目录站的第二条收录通道怎么用起来
 R
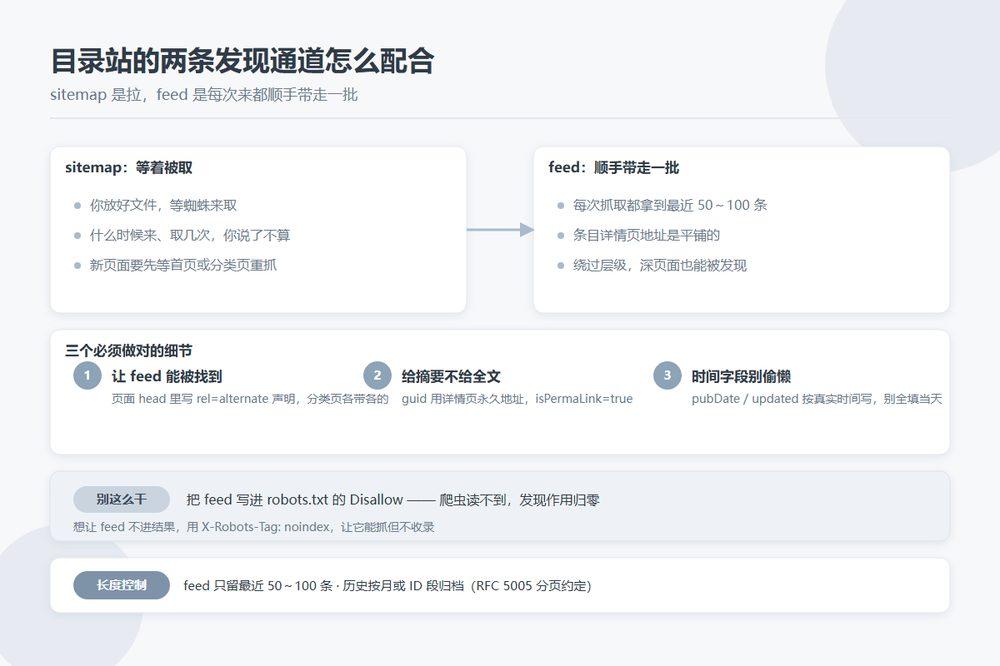
说到让搜索引擎发现新页面,多数人第一反应是 sitemap。目录站尤其依赖它——每天上架几十个条目,全靠一个 XML 文件往外推。但 sitemap 是个"拉"的机制:你放在那儿,等蜘蛛来取,它什么时候来、取多少次,你说了不算。还有一条路经常被忽略,就是 feed。
图片来源:网络,版权归原作者所有,侵权请联系删除
feed 在目录站上不是给读者订阅用的
早年的个人博客挂一个 RSS 图标,是给人订阅的。目录站不一样,你的读者根本不会用阅读器订阅一个导航站,他们直接访问首页。但这不妨碍 feed 变成一个很好用的东西:它是一个永远指向"最新"的入口。
蜘蛛每次抓你的 feed,都能一次性拿到最近 50 条、100 条条目的详情页地址。这些链接跟着 feed 一起被带出去,绕开了"新页面要等首页或分类页被重新抓取才会被发现"这条链路。对层级深的条目页来说,这个差别很明显——首页只链得到几十个,分类页更深,而 feed 是平铺的。
三个必须做对的细节
1. 让 feed 能被找到
页面上要写声明,别只在页脚放一个图标链接:
<link rel="alternate" type="application/rss+xml"
      title="最新收录站点" href="https://example.com/feed/new.xml">
分类页可以各带各的 feed,比如设计类目页声明设计类目的 feed。这样蜘蛛在设计分类页抓到的 feed,指向的全是设计类条目,主题更集中。
2. 全文还是摘要
除非你就是想做内容分发,否则目录站的 feed 一律给摘要。条目简介、站点名、类目、详情页链接,够了。全文 feed 有两个麻烦:一是聚合站整篇搬走之后,你的详情页在原创性上就不占优了;二是会出现"内容在 feed 里比在页面上还全"的怪事,蜘蛛判断主次的时候会犯糊涂。
RSS 里每个 item 的 <guid> 保持 isPermaLink="true",值就是详情页的永久地址。别用自增 ID 当 guid,那样等于放弃了一次给出规范链接的机会。
3. 时间字段别偷懒
RSS 的 <pubDate>、<lastBuildDate>,Atom 的 <updated>,都要按 RFC 822 / ISO 8601 老老实实写。有些站图省事,每次生成 feed 时把所有 item 的时间都写成当前时间,等于告诉蜘蛛"我这儿全是新东西",这种信号被识破一次,后面就不值钱了。
feed 太长怎么办
几千个条目的站,如果 feed 一次性输出全部,文件能有几百 KB,蜘蛛抓一次不划算,你也白耗带宽。常见做法是 feed 只保留最近 50~100 条,历史部分按月份或按 ID 段归档。需要严格一点的话可以参照 RFC 5005 的分页归档约定,用 rel="next"、rel="prev"、rel="first"、rel="last" 把一串 feed 串起来。
两个容易踩的冲突
第一个:有人觉得 feed 不该出现在搜索结果里,于是把 feed 路径写进 robots.txt 的 Disallow。这一挡,发现作用直接归零——爬虫根本读不到文件,里面的链接自然也发现不了。真不想让 feed 进结果,用响应头 X-Robots-Tag: noindex,让爬虫能抓、但不收录这个 URL。
第二个:feed 里塞了太多东西——整页 HTML、站内样式、统计脚本。feed 是给机器读的,保持干净。生成完之后用浏览器打开源文件看一眼,乱码、转义错的 &、没闭合的标签,都是常客。
它现在还有谁在读
除了传统搜索引擎,这两年读 feed 的客户端多了一类:各类 AI 抓取管道和聚合工具普遍把 RSS 当成结构化程度高、更新稳定的源。你把 feed 做好,未必马上看到流量变化,但它是一条不依赖任何单一平台的通道,成本也就几十行模板代码。