
X-Robots-Tag:图片、PDF、下载包这些没地方写 meta 的怎么控制索引
 X
robots.txt 管的是抓不抓,meta robots 管的是收不收。这两句话大部分人都听过,但后面还有半句常被忽略:meta 标签只能写在 HTML 文档里,遇到图片、PDF、压缩包、JSON 接口,你连写的地方都没有。
图片来源:网络,版权归原作者所有,侵权请联系删除
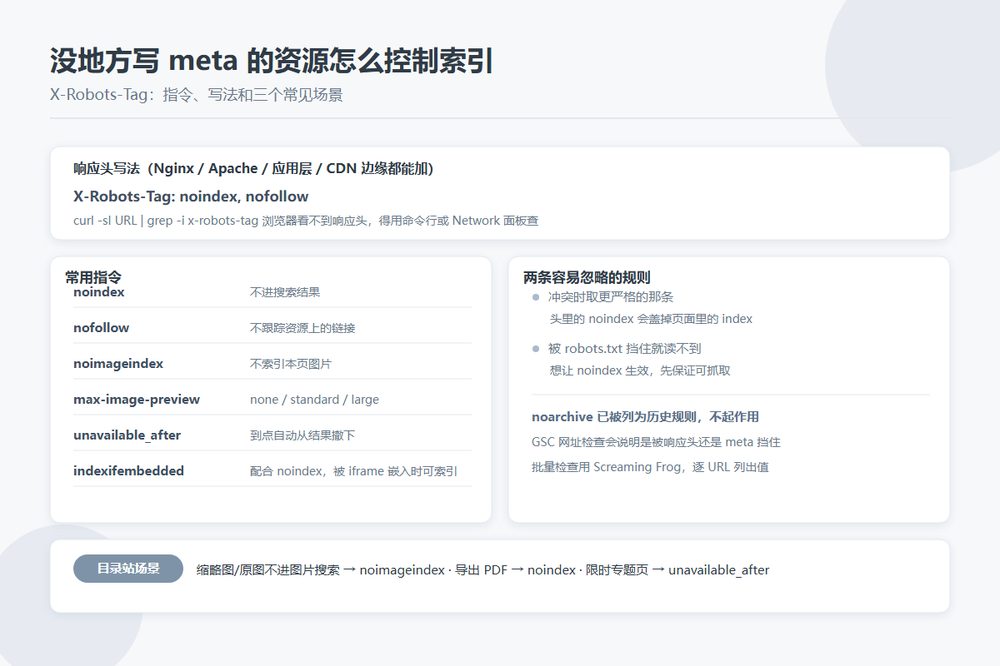
响应头版的 robots 指令
X-Robots-Tag 就是干这个的。它不是一个正式标准,属于事实标准,主流搜索引擎都认。写法是服务端在响应里加一个头:
HTTP/1.1 200 OK
Content-Type: application/pdf
X-Robots-Tag: noindex, nofollow
meta 标签里能用的指令,头里基本都能用:
noindex不进搜索结果nofollow不跟踪这个资源上的链接(对 PDF 内的超链接有效)none等于 noindex + nofollownoimageindex不索引这个页面上的图片nosnippet不显示文字摘要max-snippet:[n]摘要最多 n 个字符max-image-preview:[none|standard|large]控制图片预览尺寸max-video-preview:[n]视频预览最长 n 秒notranslate不提供翻译版本unavailable_after:[日期]过了这个时间从结果里撤下indexifembedded配合 noindex 用,被 iframe 嵌入时仍可索引
有一点要注意:noarchive 现在在 Google 的文档里已经被列为历史规则,实际不起作用,别再指望它。
可以只针对某一家
在指令前加上爬虫名,就只对它生效:
X-Robots-Tag: noindex
X-Robots-Tag: googlebot: noimageindex
上面这两行的意思是:所有爬虫都别索引这个 URL,Google 另外还别索引它里面的图片。规则冲突时取更严格的那条,所以如果你在页面里写了 index,响应头里却躺着 noindex,最终按 noindex 处理——这种"头覆盖页面"的情况排查起来很费时间,因为浏览器查看源代码是看不到响应头的。
服务器怎么写
Nginx 按路径匹配,两个坑要避开:add_header 默认只对 2xx 和 3xx 生效,得加 always;子 location 里一旦写了 add_header,就不会继承父级的。
location ~* \.(pdf|docx?|xlsx?|zip|rar)$ {
    add_header X-Robots-Tag "noindex, nofollow" always;
}
Apache 用 mod_headers:
<FilesMatch "\.(pdf|docx?|zip)$">
  Header set X-Robots-Tag "noindex, nofollow"
</FilesMatch>
动态生成的文件匹配不到扩展名,就在应用层加。PHP 一行 header('X-Robots-Tag: noindex');,Express 里 res.set('X-Robots-Tag','noindex'),都行。CDN 和边缘函数也能加,对没法改服务器配置的托管环境最省事。
目录站的三个常见场景
缩略图和原图不想进图片搜索
目录站会抓很多站点图标、截图,这些图本身没什么搜索价值,进图片搜索反而占抓取预算。在图片目录上加 X-Robots-Tag: noimageindex,或者在条目页上加,都能生效。如果希望保留缩略图展示但不要大图预览,用 max-image-preview:standard;反过来,想让内容有机会进 Discover 的大图位,就得是 large。
导出的榜单、报告 PDF
有些目录站会做"年度站点榜单"之类的 PDF。如果希望它被搜到,什么都别加,正常让它索引;如果是内部用的导出件,就 noindex。这里最容易出错的是把 PDF 目录写进了 robots.txt 的 Disallow——被挡住之后爬虫根本看不到你的 noindex,页面照样可能因为外链出现在结果里,只是没有摘要,反而更难看。
限时活动页
unavailable_after 是给这类页面准备的。日期支持 RFC 822、RFC 850、ISO 8601,写清楚时区:
X-Robots-Tag: unavailable_after: 2026-12-31T23:59:59+08:00到点之后搜索引擎会自动把它从结果里撤下,不用你手动处理。对"双十一专题""年终盘点"这类有时效的聚合页很省事。
怎么验证加上了没有
命令行最直接:
curl -sI https://example.com/files/list.pdf | grep -i x-robots-tag浏览器开发者工具的 Network 面板里看响应头也行。Search Console 的网址检查会明确告诉你这个 URL 是被 noindex 挡住的,如果是被响应头挡的,也会说明来源。批量检查的话,Screaming Frog 之类的爬虫工具会把每个 URL 的 X-Robots-Tag 值列出来。