
失败了就重试,是目录站最容易写错的那行代码
 失
后台任务失败的默认处理,很多代码里就一句:失败了重新丢回队列。写的时候觉得没问题,出事那天才发现重跑一次和跑两次的后果完全不一样。
图片来源:网络,版权归原作者所有,侵权请联系删除
第一道保险:幂等键别从内容哈希里取
重试安全的含义是同一个任务跑一次和跑三次结果相同。要做到这一点,得先有个稳定的身份。
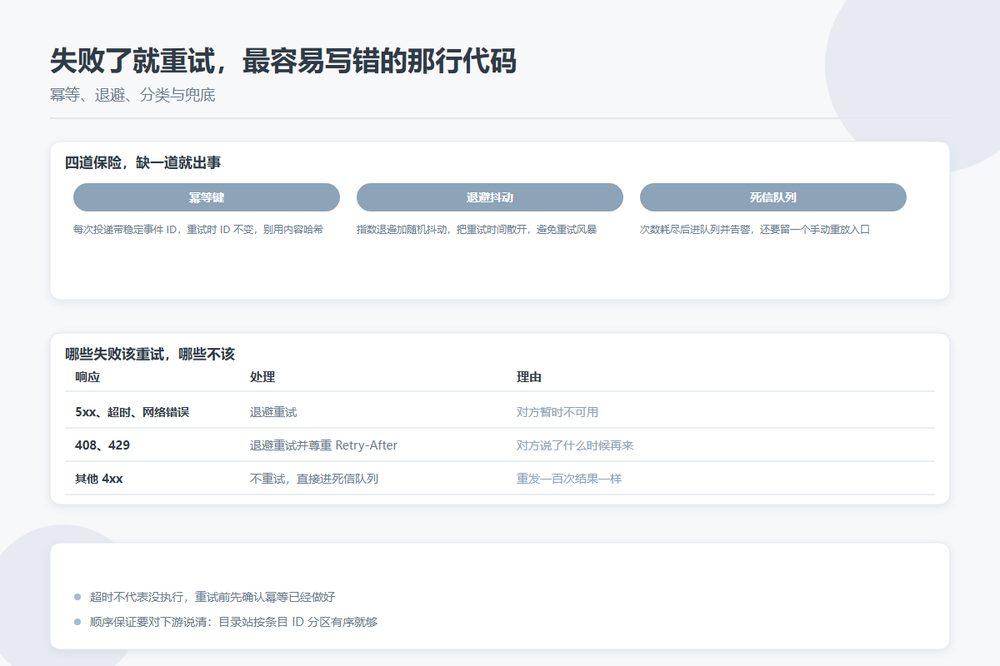
常见的错误是用任务内容的哈希当去重键。两条不同的业务事件可能生成一模一样的内容——站点 A 和站点 B 在同一分钟被巡检、内容字段恰好相同——哈希一样,第二条就被当成重复丢掉了。正确做法是每次投递都带一个稳定的事件 ID,重试时 ID 不变,接收方记住处理过的 ID,再见到就直接返回成功。
这个 ID 的存储时长要大于你的最大重试窗口。重试能持续一天,去重记录只留两小时,那么一天前的事件重放进来还是会被当成新事件处理一遍。
第二道保险:退避必须带抖动
固定间隔重试的问题在并发下才暴露:一千个任务同时失败,一分钟后同时重试,把刚恢复的下游再打一次。这就是重试风暴。
标准写法是指数退避加抖动,delay = min(上限, 基数 × 2^次数) × random(0.5, 1.0),让重试时间散开。次数要有硬上限,比如六次,间隔大致走 1 分钟、5 分钟、30 分钟、2 小时、12 小时、24 小时这一档,总窗口在一天半左右。
第三道保险:不是所有失败都该重试
按状态码分,判断规则很清楚:
- 该重试的:5xx、408、429,以及连接超时、读取超时这类网络错误。对方临时不可用,等一等可能就好。
- 不该重试的:400、401、403、404、422。对方明确拒绝了这次请求,重发一百次结果一样,只是白白占用队列。
- 要特别处理的:429 和 503 通常带着 Retry-After 响应头,按它给的时间等,别自己拍脑袋定间隔。
有一条例外要记住:超时不代表没执行。请求发出去了,对方处理完了,只是响应没回来。这种情况重试,前提是幂等已经做好,否则就是重复执行。
第四道保险:耗尽之后要有地方去
重试次数用完之后,任务不能凭空消失。做法是丢进死信队列,同时发出告警信号:队列长度、最老任务的年龄、按任务类型的失败率,这三个数上墙。
死信队列还需要一个能手动重放的入口。修完下游的问题,运维要能把这批任务重新放回去跑,而不是删掉重来。没有重放入口的死信队列,最后一定会变成没人敢看的黑洞。
顺序这件事要提前说清
最后一个设计决策是顺序保证,而且要对下游说清楚,不要让人猜:
| 保证级别 | 含义 | 代价 |
|---|---|---|
| 尽力而为无序 | 可能乱序,也可能重复 | 最省事,多数场景够用 |
| 按资源有序 | 同一个条目 ID 的事件按产生顺序到达 | 队列按资源键分区 |
| 全局有序 | 所有事件一个总顺序 | 基本等于单写单读,很贵 |
目录站的条目状态变更通知选第二种就够:按条目 ID 分区,同一个条目的"审核通过"和"上架"不会颠倒。不同条目之间谁先谁后无所谓。另外在每个事件里带上一个单调递增的序号,接收方就能自己发现漏了或者乱了,去拉一次全量对账。
重试不是容错,是把失败往后推。真正让系统稳下来的,是幂等、退避、分类和兜底这四件事一起在场。