
到底能扛多少:目录站的压测该测什么,结论怎么用
 到
压测最常见的失败不是技术上的,是目标没写清楚就开始跑。跑完拿到一堆数字,没人知道它意味着什么。
所以在打开工具之前,先把三件事写下来:要保护的是哪些页面、能接受的响应时间是多少、以及超限之后要做什么。
图片来源:网络,版权归原作者所有,侵权请联系删除
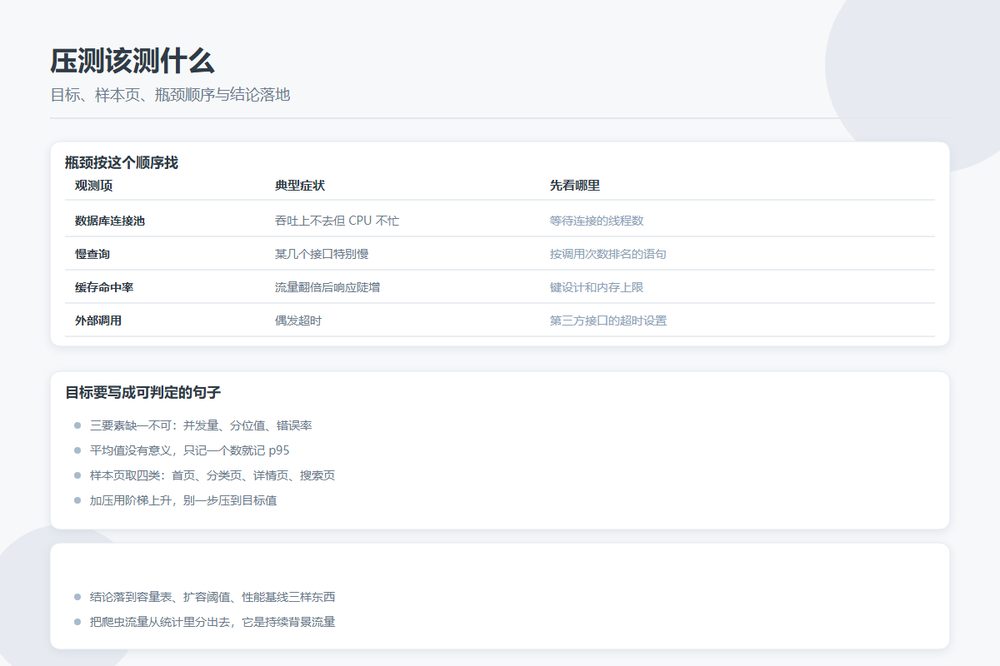
目标要写成可判定的句子
「首页要快」不是目标,「首页在 200 并发下 p95 低于 800 毫秒、错误率低于 0.5%」才是。三个要素缺一不可:并发量、分位值、错误率。平均值没有意义,它会被大量快请求拉平,掩盖掉那一小撮特别慢的。
推荐用 p95 或 p99。如果一次压测只记一个数,记 p95。
样本页选四类就够
目录站的页面形态不多,按四类取样能覆盖绝大部分流量:
- 首页:链接最多、模块最杂,通常是渲染最重的一页
- 分类页:有分页和筛选,数据库查询模式不同
- 条目详情页:量最大,缓存命中与否差别巨大
- 搜索页:最容易成为瓶颈,尤其是未命中缓存的查询
每类取真实的 URL,不要用构造出来的假地址——假地址可能命中不了真实的数据分布,测出来的数字偏乐观。
环境和工具
不要在业务高峰期压生产环境。要么用一套配置相同的预发环境(注意别让它被搜索引擎抓到),要么选凌晨低峰、提前备好随时中止的手段。
工具按需要选:k6 和 Locust 用脚本描述场景,适合复杂的多步骤流程;wrk 和 ab 适合单 URL 的极限吞吐测试。目录站用前者就够,脚本能进版本库,下次还能复跑。
加压方式是阶梯上升而不是一步到位:从日常流量的两倍开始,每档跑几分钟,观察指标有没有突变。一步压到目标值,出问题了不知道是从哪个点开始坏的。
瓶颈按这个顺序找
| 观测项 | 典型症状 | 先看哪里 |
|---|---|---|
| 数据库连接池 | 吞吐上不去但 CPU 不忙 | 等待连接的线程数 |
| 慢查询 | 某几个接口特别慢 | 按调用次数排名的语句 |
| 缓存命中率 | 流量翻倍后响应陡增 | 键设计和内存上限 |
| CPU | 全站一起变慢 | 模板渲染、图片处理 |
| 外部调用 | 偶发超时 | 第三方接口的超时设置 |
顺序是有讲究的。连接池等待和慢查询是最常见的两个原因,而且都不需要加机器就能改善。先花时间在这两处,比直接扩容划算。
结论要落到容量表
压测的最终产出不是一份报告,是三样能用的东西:
- 容量表:每类页面在当前配置下的安全并发上限
- 扩容阈值:达到什么指标就加机器,提前写死,别等出事再讨论
- 性能基线:每次大版本发布前复跑一次,和基线对比,退化超过 15% 就揪出来
另外记得把爬虫流量从统计里分出去。搜索引擎的抓取是持续的低频背景流量,它不会造成尖峰,但会占用连接数,压测建模时可以按固定比例留出来。
一次压测的价值不在于那个最大数字,而在于知道「从哪个点开始出问题」以及「出问题的是哪一层」。这两个信息能让你在真正的流量高峰到来前就把短板补上。