
只知道慢不知道慢在哪:目录站后端链路追踪该埋哪几个点
 只
指标、日志、链路是可观测性的三块。指标回答「有没有问题」,日志回答「发生了什么」,链路回答「时间花在哪了」。
目录站的后端通常不复杂:网关或 CDN、应用、缓存、数据库,加几个定时任务。但正因为简单,很多团队觉得不需要链路追踪,出问题就靠猜和加日志。等页面从 200 毫秒变成 2 秒,猜的成本就上来了。
图片来源:网络,版权归原作者所有,侵权请联系删除
先想清楚要回答什么问题
上链路追踪之前,先列两三个你真正想回答的问题。工具选型和埋点密度都取决于这个。
对目录站来说,通常就三个:一个请求的时间到底分给了谁;某个慢请求是数据库慢、缓存慢、还是外部调用慢;抓取量下降的时候,爬虫请求是不是卡在某个环节。
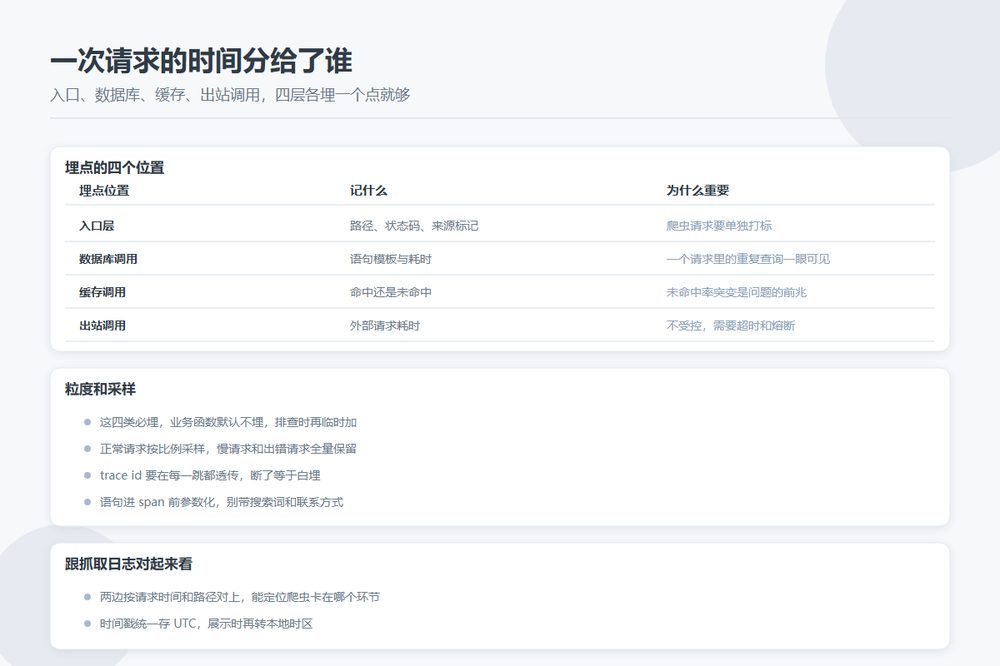
埋点的四个位置
入口层
在请求进入应用时开一个 span,记录方法、路径、状态码、总耗时。这一层最关键的是要区分请求来源——用户请求、爬虫请求、内部调用分开打标。
区分爬虫的意义在于:爬虫请求的路径和普通用户不一样,它更集中在列表页和 sitemap,而且对失败更敏感。混在一起看,爬虫侧的问题会被量大的用户请求淹没。
数据库调用
每一个查询记一条 span,带上语句模板(参数要脱敏)和耗时。这一层最有价值,因为目录站的性能问题大多出在这里。
这里跟 N+1 那类问题正好接上:链路视图里一眼能看出「一个请求里五十条几乎相同的查询」,比翻日志快得多。
缓存调用
要记录命中还是未命中,不只是耗时。缓存未命中本身不是问题,但「某个 key 未命中率突然从 5% 变成 80%」是问题的前兆。
目录站上常见的缓存异常是碎片化:Vary 头设得太宽(比如带了 User-Agent),同一个页面存出几十个变体,命中率掉到很低但没人发现。
出站调用
目录站有不少对外请求:抓对方 favicon、检测外链是否还活着、调第三方接口。这些调用的延迟不受你控制,但会拖慢你的页面。
这一层要单独设超时和熔断。外部站点响应慢是常态,不能让它把应用线程池占满。
粒度:别什么都埋
把所有函数调用都埋上,数据量会大到存不起、查不动,而且噪音淹没信号。
实用的做法是分层:入口、数据库、缓存、外部调用、异步任务这五类必埋;业务逻辑内部的函数调用默认不埋,排查时再临时加。
采样也要配。全量采样对高流量站点不现实,常见做法是正常请求按小比例采样,慢请求和出错请求全量保留。这样既控制了成本,又保证出问题的那些请求一定能查到。
跟抓取日志对起来看
这是目录站能用出花来的地方。服务器日志有爬虫的请求记录,包括 URL、状态码、响应时间;链路数据有这个请求内部的耗时拆分。两边用请求时间和路径对上,就能回答一些以前答不上来的问题。
比如:爬虫请求某个分类页总是超时。看日志只知道是 500 或者超时,看链路才知道是那个分类下的条目数特别多、关联查询爆了,还是页面里某个外部调用卡住了。
再比如:抓取量下降之前,是不是有一段时间爬虫请求的错误率在缓慢上升。这类趋势用日志单独看不明显,配上链路的内部耗时就能看出转折点在哪个环节。
前提是两边的时间戳要对齐——统一用 UTC 存,展示时再转本地时区。这条看着基础,实际对不上的情况特别多。
三个能直接落地的用法
慢请求自动留证
设一个阈值,超过就完整保留这条链路的所有 span,不管采样率是多少。排查的时候不用复现,直接翻记录。
发版前后对比
性能回归不只看 Lighthouse 分数。后端这一侧,把发版前后的 p50、p95 和各层耗时占比拉出来对比,能定位到是哪个环节退化的。这比「感觉慢了」可靠。
给定时任务单独建链路
异步任务没有请求上下文,很多人就不埋了。但目录站的巡检、缩略图生成、索引重建这类任务,慢起来一样影响业务——条目更新延迟、lastmod 不准,最后反映到收录上。给任务加一个 trace,跑多久、卡在哪一步就有数了。
几个坑
trace id 没有透传。请求跨服务时 trace id 丢了,链路断成两段,等于白埋。要确认 HTTP 头里的 traceparent 之类的字段在每一跳都传下去。
语句里带敏感信息。SQL 语句进 span 前要参数化处理,用户提交的搜索词、手机号这类不能直接进追踪系统。
只埋不看。装了工具、配了采集,没有一个人定期翻。建议把链路视图的链接直接放进告警消息里——告警响的时候点开就是那条慢请求的完整链路,这个闭环能让工具真正被用起来。