
一次导入三千条:目录站批量导入的字段映射、去重键和那几个编码坑
 一
目录站的数据来源越来越杂:自己收录的、合作方给的、从旧站迁过来的、从公开列表整理的。每一批进来都要过一遍导入流程,而这个流程做不扎实,清理成本是导入成本的十倍。
图片来源:网络,版权归原作者所有,侵权请联系删除
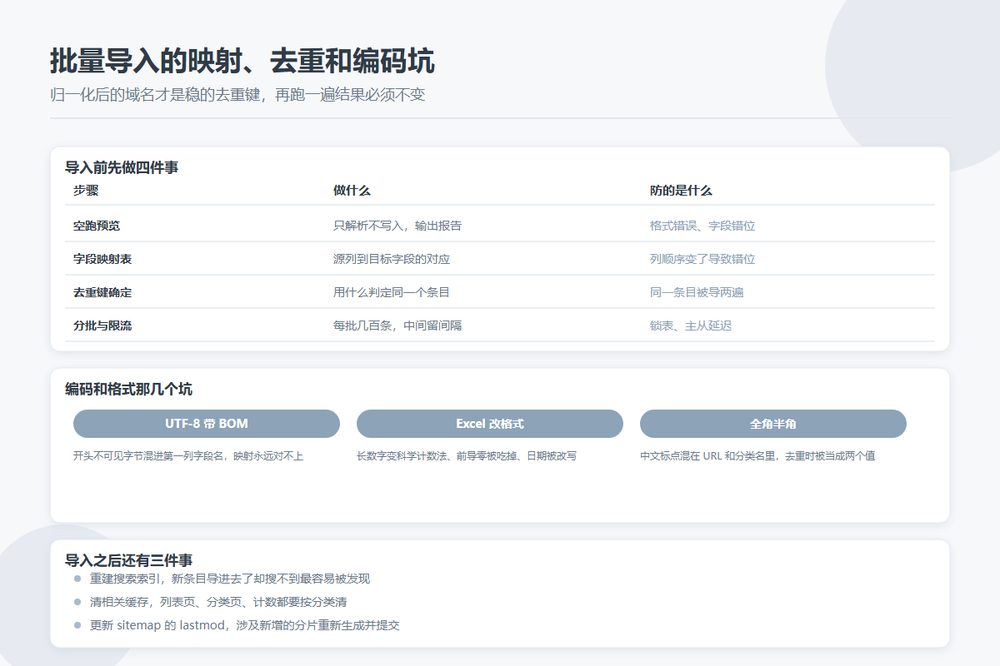
导入前先做四件事
| 步骤 | 做什么 | 防的是什么 |
|---|---|---|
| 空跑预览 | 只解析不写入,输出报告 | 格式错误、字段错位 |
| 字段映射表 | 源文件列到目标字段的对应 | 列顺序变了导致错位 |
| 去重键确定 | 用什么判定是同一个条目 | 同一条目被导两遍 |
| 分批与限流 | 每批几百条,中间留间隔 | 锁表、主从延迟 |
空跑这一步最容易被跳过,也最不该跳。它不写任何数据,只告诉你这份文件里有多少行能解析、多少行的必填字段是空的、多少个站名疑似重复。这个报告看一遍,胜过导入之后在数据库里大海捞针。
编码和格式那几个坑
UTF-8 带 BOM 是最经典的一个。文件开头那几个不可见字节会被当成第一列字段名的一部分,表现是第一列的映射永远对不上,而你在编辑器里怎么看都正常。
Excel 的问题更隐蔽。打开 CSV 再保存,它会自作主张地把长数字转成科学计数法、把前导零去掉、把看起来像日期的内容改成日期格式。站点 URL 一般没事,但条目编号、电话、某些编号类字段会被改得面目全非。规矩是:CSV 用文本编辑器或者脚本生成,别用表格软件来回倒。
全角半角也值得提一句。全角冒号、全角括号、中文逗号混在 URL 和分类名里,肉眼几乎看不出,去重的时候会被当成两个不同的值。导入前统一做一次字符规范化,把全角标点、多余空格、不可见字符清掉。
去重键怎么定
用站名去重不可靠,同一个站有简称有全称。用自增 ID 也不行,那是你自己生成的,跨批次没有意义。
归一化后的域名才是稳的去重键:去掉协议、去掉 www、去掉末尾斜杠、路径和参数按规则处理、统一小写。这一步做完,同一站点在不同批次里才会被认作同一个。需要注意后缀判断要基于公共后缀列表,别自己用最后一个点去切,很多后缀是两级的。
域名之外再备一个次键,比如站名加分类的组合,用来处理同一域名下有多个不同服务的少见情况。主次键都撞上才判为重复,误杀率会低很多。
幂等:再跑一遍结果不变
导入脚本要满足一个基本要求:同一份文件跑两次,数据库里不会多出一倍数据。做法是按去重键做存在性判断,已存在就更新指定字段,不存在才插入。这样中途失败后重跑是安全的,不用先清库。
配合幂等的还有一件事:把每次导入的批次号写进数据。出了问题能直接定位是哪一批带进来的,按批次回滚也是可能的,不用全表扫描。
失败要能退回去
三千条导到一半报错,剩下的一千五百条是导还是不导?答案取决于有没有事务边界。整批在一个事务里,报错就整体回滚,干净但锁表时间长;分批提交,失败了要知道断点在哪,能从断点继续。目录站一般用后者,每批提交一次,批次号记录进度。
无论如何,导入前先备份那张表。这一条说了一百遍还是有人不做。
导入之后还有三件事
- 重建搜索索引。新条目导进去了但站内搜索搜不到,是最容易被用户发现的疏漏。
- 清相关缓存。列表页、分类页、计数相关的缓存都要按分类清,别只清首页。
- 更新 sitemap 的 lastmod,涉及新增条目的分片重新生成并提交一次。导完了不提交,等于这批数据要等爬虫自己发现。
这三件事做成导入流程的最后一步,写进脚本里,别靠人记。