
自动抓对方网站信息这件事:目录站的 User-Agent、频率和 robots 该怎么守规矩
 自
目录站的日常离不开自动抓取:新提交一个站点,要拿它的标题、描述、favicon、可能的截图;存量条目要定期检查是不是还活着。这些动作都要用程序去抓别人的网站。
写一个能跑的抓取器很容易,写一个不会给自己惹麻烦的抓取器才是难的部分。对方站长把你拉黑、搜索引擎顺着投诉找上门、甚至收到律师函,都源于细节没做好。
图片来源:网络,版权归原作者所有,侵权请联系删除
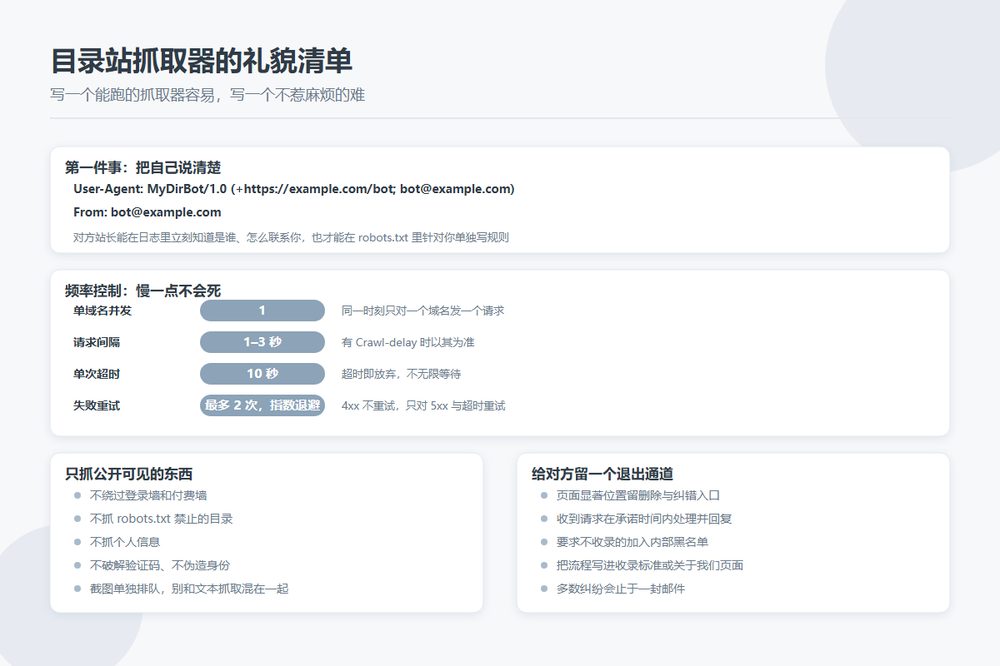
第一件事:把自己说清楚
礼貌抓取的第一条是声明身份。一个负责任的 User-Agent 应该包含机器人名称、站点域名和联系方式:
User-Agent: MyDirBot/1.0 (+https://example.com/bot; bot@example.com)
From: bot@example.com
为什么要这么做:
- 对方站长在日志里看到异常流量时,能立刻知道是谁、怎么联系你,而不是直接封 IP
- 对方可以在 robots.txt 里针对你的 bot 单独写规则
- 出问题时对方会先发邮件而不是先投诉
反过来,用浏览器默认的 UA 假装自己是真人访问,是最容易引起反感的做法。一旦被发现,封禁几乎必然。
robots.txt 必须遵守,包括 Crawl-delay
抓之前先取一次 robots.txt 并按规则来,这是底线。要注意几个细节:
- 匹配规则要按最长路径优先,不是按顺序匹配。很多自己写的解析器在这里出错。
Disallow的路径不抓,这是硬性的。对方明确写了不能抓的目录,抓了就是明知故犯。- Crawl-delay 这个指令虽然不是所有搜索引擎都支持(Google 明确不支持),但对方写在那里就是给你的请求频率建议,照做是基本礼貌。
- robots.txt 取到 404 视为全部允许;取到 5xx 应当暂时停止抓取,而不是当作放行。
- 规则要缓存,别每次请求都重新拉一遍 robots.txt,那本身也是一种骚扰。
频率控制:慢一点不会死
目录站最容易犯的错,是批量更新时一次性并发几百个请求打向同一个域名。对方小站可能直接被你打挂。
一套保守但够用的参数:
| 项目 | 建议值 | 说明 |
|---|---|---|
| 单域名并发 | 1 | 同一时刻只对一个域名发一个请求 |
| 单域名请求间隔 | 1–3 秒 | 有 Crawl-delay 时以其为准 |
| 单次抓取超时 | 10 秒 | 超时即放弃,不无限等待 |
| 失败重试 | 最多 2 次,指数退避 | 4xx 不重试,只对 5xx 和超时重试 |
| 整站抓取上限 | 按站点规模设上限 | 防止误入无限翻页的陷阱 |
另外,抓一次就缓存结果。标题、描述、favicon 这类信息不需要每次展示都重新抓,存下来按周或按月更新即可。多数「抓取器被封」的事故,本质都是重复抓取造成的浪费。
只抓公开可见的东西
几个明确的禁区:
- 不绕过登录墙和付费墙。需要登录才能看到的内容,不要在未授权的情况下抓取。
- 不抓 robots.txt 明确禁止的目录,尤其是带敏感信息的路径。
- 不抓个人信息。联系方式、个人主页这类信息如果对方没有公开明示,不要入库。
- 不破解验证码、不伪造身份。对方上了验证码就是在拒绝自动化访问,硬闯属于对抗行为。
给对方留一个退出通道
这是很多目录站忽略的一步,但非常重要:提供被收录站点要求删除或修改的渠道。
- 在页面显著位置留一个联系邮箱或表单,专门用于条目纠错与下架
- 收到删除请求后在承诺时间内处理,并回复处理结果
- 对明确要求不收录的站点,加入内部黑名单,防止被再次自动抓回
- 把这套流程写在「收录标准」或「关于我们」页面里,既是服务承诺,也是免责依据
有了这条通道,绝大多数纠纷都会止于一封邮件,而不是升级成投诉。
截图服务要单独说一句
如果目录站要展示站点截图,通常要用无头浏览器去渲染对方页面。这比抓 HTML 重得多,注意两点:
- 截图单独排队,与文本抓取分开限速,避免一次批量截图把对方服务器拖慢
- 只渲染首屏,禁止执行会触发交互的脚本,并且不要提交表单、不要点击按钮
一份抓取器的自检清单
- User-Agent 里写了机器人名、站点域名和联系邮箱
- 请求带
From头 - 抓之前取 robots.txt,按最长路径匹配,缓存规则
- 尊重 Crawl-delay,单域名并发为 1,请求间隔 1–3 秒
- 有超时、有限次重试,4xx 不重试
- 抓取结果入库缓存,不重复抓
- 不绕过登录墙,不抓个人信息
- 页面上有删除与纠错的联系渠道,并在承诺时间内响应
抓取器的礼貌程度,决定了这个目录站能活多久。对方站长愿意配合,你的条目数据才准;把人惹毛了,等着你的是投诉和封禁。