
备份这件事没人管:目录站的数据库、上传目录和配置该怎么留底,以及怎么演练恢复
 备
目录站的数据很皮实:条目基本是静态的,一天也改不了几条。正因为变化慢,备份这事容易被拖——反正昨天和今天差不多,快照留着就行了。直到某天云盘满了、误删一张表、或者服务商整机房下线,才发现所谓「有备份」指的是三个月前手动导出的一个 SQL 文件。
图片来源:网络,版权归原作者所有,侵权请联系删除
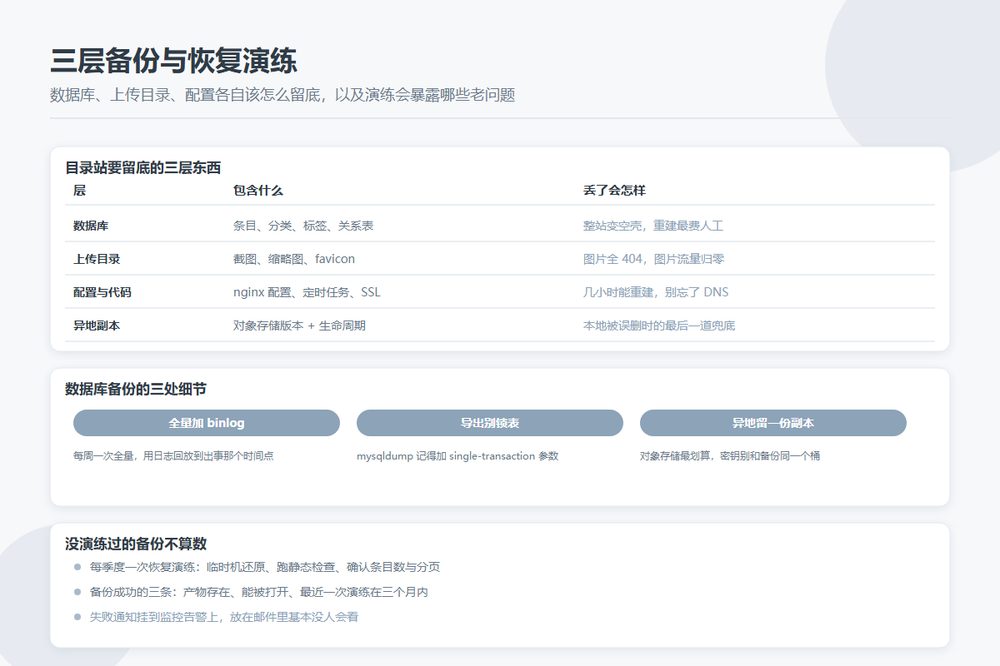
目录站要留底的三层东西
| 层 | 包含什么 | 丢了会怎样 |
|---|---|---|
| 数据库 | 条目、分类、标签、描述、关系表 | 整个站变空壳,重建最费人工 |
| 上传目录 | 截图、缩略图、favicon 副本 | 图片全 404,图片搜索那条流量归零 |
| 配置与代码 | nginx 配置、定时任务、SSL 证书、环境变量 | 能在几小时内重建,但别忘了 DNS |
三层的恢复难度差别极大,备份策略不该一刀切。数据库是唯一必须精确到分钟的;上传目录允许用对象存储的版本功能慢慢兜;配置文件最省心的方式是压进代码仓库,谁改了留痕,还能回滚。
数据库:别只留一份全量
只做一份每日全量 mysqldump,是很多小站的全部备份。它能救的场景有限:只能恢复到出事那天的零点,白天录入的几百条全部作废。
实用的组合是全量加增量。每周一次全量导出,同时开启 binlog,把两次全量之间的日志也留下来。真出事时用「最近那次全量 + 之后的 binlog」回放到具体时间点,理论上能精确到秒。这个组合的成本只是多开一个二进制日志文件和一小段磁盘。
导出的时候注意加 --single-transaction,不然大表导出会锁表,站上的列表页在导出期间会卡住。文件落地后别留在同一台机器上——这点听上去是废话,但真这么干的人不少:dump 到 /root/backup/,然后磁盘坏了。
异地那份用什么都行,对象存储最划算。开版本控制,配一条生命周期规则,30 天后的旧版本自动转入低频存储。密钥别和备份文件放同一个 bucket。
上传目录是最容易忘的那层
数据库没了还能重录,图片没了才是真的丢。一张是自动生成还好,麻烦的是那些当年手工修过的截图——裁剪过 Logo、修过水印的那批,这些信息在数据库里没有,重建只能重新截。
关键是URL 不能变。目录站的图片 URL 一般形如 /zb_users/upload/2026/10/xxx.jpg,如果站点搬家后 URL 变了,那批已经被收进图片搜索的图会集体 404,之前积累的图片流量一夜间归零。所以恢复上传目录时务必按原路径结构还原,任何重写 URL 的想法都该在这一步就被否掉。
做法很直接:把整个上传目录做一次单向同步到对象存储(rsync 或 rclone sync 都行),每天跑一次,删文件的时候用延迟删除或者干脆也同步过去。同步带宽成本很低,几千个文件几十 MB。
配置层:进代码仓库,别靠记忆
nginx 的 server 块、重定向规则、定时任务清单、SSL 证书和私钥、脚本里的环境变量。这些东西平时没人动,动的时候一定是在半夜救火。
把配置目录做成私有 Git 仓库,加上 README 写清楚每份文件是干什么的。私人信息(数据库密码、CDN 密钥)用 .env 示例文件占位,实际值另外存在密码管理器里,不要图省事一起传。SSL 私钥如果要放,记得仓库必须是私有的——私钥泄露的严重性比备份丢失还高。
没演练过的备份不算数
这条是整篇文章唯一必须执行的动作:每季度做一次恢复演练,在一台临时机器上用备份完整还原,跑一遍静态检查,确认条目数量、分页列表正常、图片返回 200。
演练会暴露所有平时看不见的问题。最常见的三个:dump 命令的参数写错了导致导出的是空文件(文件存在、体积几十 KB,肉眼根本不会多看一眼);对象存储的权限过期了,几个月前就同步失败;打包脚本里写死了某个已经被删掉的目录。
演练完记一份恢复耗时。这个数字决定了你的 RTO(恢复时间目标)——如果你花三小时才恢复完成,那一周一次全量备份就太少了,因为最多可能丢七天数据、再加三小时不可用。对目录站来说,一天一次全量 + binlog 是性价比最高的配置。
什么才算「备份成功了」
不是脚本没报错就算。要同时满足三条:产物存在且体积跟上次相比没有异常缩小;文件能用 mysql 或归档工具正常打开;最近一次恢复演练在三个月内。缺任何一条,都当作没有备份处理。
最后一条建议:把备份失败的通知做成会响的那种。放在邮件里没人看,挂在监控告警上,失败就推送到手机——备份故障的特点是它永远安安静静,直到你真正需要它的那天。