
nginx 装好能跑不等于配好了:目录站要改的那几个默认值
 n
装完 nginx 配好 server 块能打开页面,这件事很容易给人一种「服务器已经好了」的错觉。实际上默认配置是一份给通用场景的折中值,它没考虑你有几千个页面每天被爬虫反复访问,也没考虑你要传截图。
图片来源:网络,版权归原作者所有,侵权请联系删除
先算一笔账:默认并发上限很低
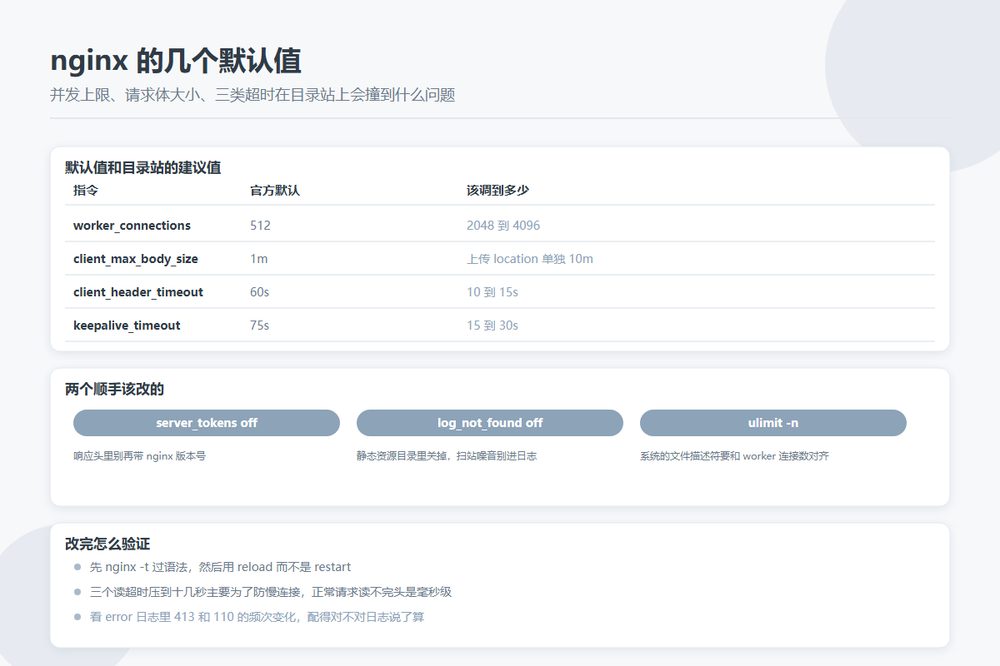
nginx 的事件块里,worker_connections 的官方默认值是 512。理论最大连接数约等于 worker 进程数乘这个值。两核机器上默认开两个 worker,算下来就是 1024。
一千出头的连接数听着不少,但它要同时服务于浏览器的 KeepAlive 长连接、爬虫的并发抓取、以及上传下载。一个页面在爬虫眼里可能是一串请求,如果遇到几个爬虫同时光顾,撑不住的概率不小。而且这个值还受系统的文件描述符上限约束,光改配置不改 ulimit -n,连接数照样上不去。
目录站的建议值是 2048 到 4096,具体看机器内存。改之前先确认系统层的 nofile,两边对齐。
三个超时,各自治不同的病
| 指令 | 默认 | 管什么 | 建议 |
|---|---|---|---|
| client_header_timeout | 60s | 读完整请求头的时限 | 10 到 15s |
| client_body_timeout | 60s | 读请求体的间隔时限 | 10 到 15s |
| send_timeout | 60s | 两次写之间的间隔 | 15 到 30s |
| keepalive_timeout | 75s | 长连接空闲多久关闭 | 15 到 30s |
前两个是防慢连接攻击的。攻击者开几百条连接、每隔几秒发一个字节,永远不让请求头读完——连接数不多,但每条都占着 worker。把超时压到十几秒,这类连接很快就被踢掉。正常用户的请求头是毫秒级发完的,压到 10 秒毫无感知。
keepalive_timeout 的默认值(官方是 75 秒,有些发行版打包时改成了 65 秒,看到两者都别奇怪)对目录站偏长。爬虫和浏览器建了长连接之后会闲着,闲着也占一个连接槽。压到 20 到 30 秒,几千 URL 的抓取总时长基本不受影响,但连接被释放得快得多。
唯一的例外是运维自己要在慢网环境下载大文件:那种场景给特定的 location 单独放宽,不要全局放。
client_max_body_size 和那个 413
默认是 1M。这条阈值对目录站来说特别容易撞上:上传一张高清站点截图就可能超过。报错信息是 413 Request Entity Too Large,这个日志在 error_log 里很好认。
处理的时候注意别一刀切到几百兆。把上传接口所在的 location 单独设成 10m,其余保持默认。全局放大意味着任何地方都能接受超大请求体,被拿来当上传中转的风险就高了。
顺带把 client_body_buffer_size 一并看一眼,默认按平台是两个内存页(常见 8k 或 16k),超过的部分要落临时文件。目录站的接口请求体都不大,一般不用动,但如果你的后台有批量导入 CSV 的功能,可以把 buffer 提到 128k,减少磁盘临时文件的读写。
两个顺手该改的
server_tokens off; 默认响应头里会带上 nginx 版本号。单独这个版本号不会让你被黑,但它让攻击者省了一步探测——知道版本就能直接查该版本有哪些已知问题。关掉零成本。
日志里的 404。log_not_found off; 能让 favicon.ico、被扫的探针路径不再写进 error 日志。日志的价值在于异常可读,如果一天几千行全是扫描噪音,真正的问题就被淹了。做法是主体资源保留 404 日志,只在静态资源目录里关掉。
反向代理到 PHP-FPM 那一层
目录站多数跑 PHP,nginx 只做前置。这一层有两个默认值值得检查:一是 fastcgi_read_timeout,默认 60 秒,如果后台有导出全站数据的操作,这个值不够就会在导出到一半时空掉;二是上游的 keepalive——nginx 到 PHP-FPM 之间默认每次请求都新建连接,配置 upstream 块并开启连接复用之后,TTFB 能降一截。
TTFB 这件事对目录站的意义不用多说:搜索引擎会记录站点的响应速度,虽然它不是直接的排名因素,但它决定单位时间内能爬多少页。响应快 100 毫秒,几万个 URL 累积出来的抓取量差别是实打实的。
改完之后怎么验证
先 nginx -t 过语法,再 reload 别 restart——restart 会断掉正在进行的抓取请求。改完用 curl -I 抽查几个条目页,确认响应头、状态码、缓存头都对。
再看两处数据:一是错误日志里 413 和 110(超时)的出现频率变化,二是 Search Console 里「服务器错误」的报告曲线。改配置这件事最怕的是改完了感觉良好但从没回头看过数据——配得对不对,日志说了算。