
我的目录站日活看着挺高,一半是机器:把爬虫流量从统计里剔出去的三层过滤
 我
有段时间我的目录站统计后台显示独立访客涨了不少,但收录量和排名一点没动。查了日志才发现,新增的那部分里大部分是各种爬虫和采集器,真正的用户没变。这种虚高很常见,而且会误导决策——你以为内容受欢迎,其实只是机器人来得勤。
图片来源:网络,版权归原作者所有,侵权请联系删除
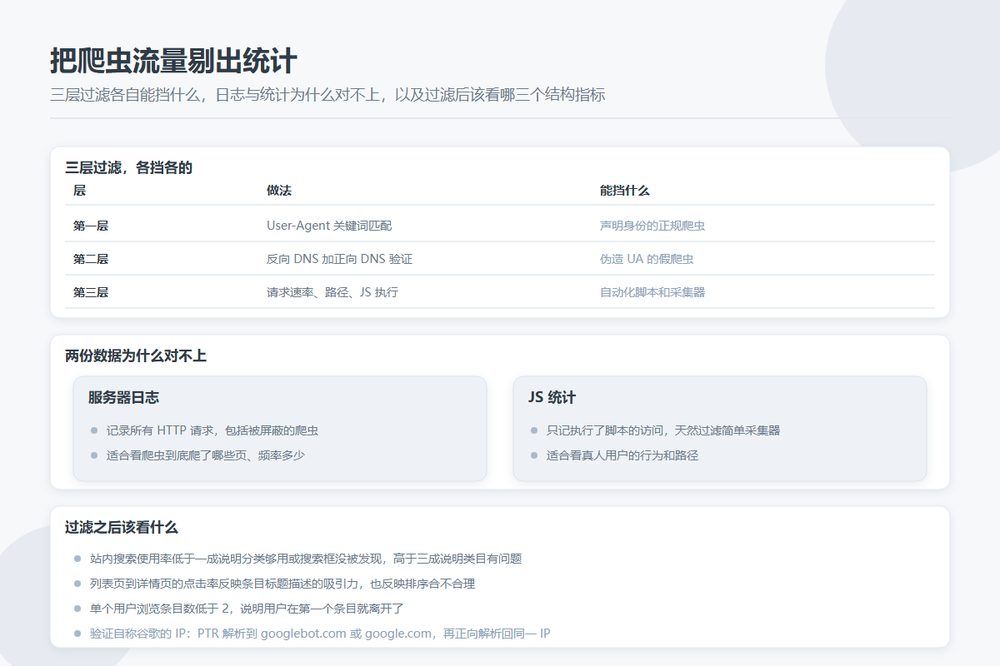
三层过滤,各挡各的
| 层 | 做法 | 能挡什么 | 挡不住什么 |
|---|---|---|---|
| 第一层 | User-Agent 关键词匹配 | 声明身份的正规爬虫 | 伪装 UA 的采集器 |
| 第二层 | 反向 DNS + 正向 DNS 验证 | 伪造 UA 的假爬虫 | 真浏览器行为的脚本 |
| 第三层 | 行为特征(请求速率、路径、JS 执行) | 自动化脚本和采集器 | 高仿的定向抓取 |
三层不是三选一,是叠加。任何单层都有明显的漏网,但三层加起来能覆盖绝大多数情况,剩下的部分对统计口径来说已经不影响判断了。
第一层:UA 匹配没那么简单
大多数人以为 UA 匹配就是判断字符串里有没有 bot 或 spider。实际要处理的问题更多:
UA 是可以伪造的,所以这一层只能剔除「诚实声明自己是机器」的那部分。好处是这部分通常量最大——搜索引擎爬虫、SEO 工具、监控服务,它们都不藏着。
维护一份关键词表,别只写几个大厂的名字。常见的还有各类 AI 训练爬虫(前面专门写过它们的区分)、社交媒体抓取器、价格监控、安全扫描器。这份表要每季度更新,新爬虫出现得很快。
注意别误伤。有些老旧浏览器的 UA 里带奇怪的字符串,还有部分企业内网代理会改写 UA。过滤规则要用完整词匹配而不是任意位置匹配,比如匹配 Googlebot 要确认它不在一段正常浏览器 UA 的中间出现。
第二层:验证自称谷歌的 IP
这一层是判断「自称是某爬虫的 IP 到底是不是」的关键。方法是两步验证:
反向 DNS:对这个 IP 做 PTR 查询,看它解析出来的主机名是不是以 googlebot.com 或 google.com 结尾。正向 DNS:再对这个主机名做 A 记录查询,确认解析回来的 IP 和原 IP 一致。
两步都要做,缺一不可。只做反向 DNS 的话,对方可以把自己的 PTR 记录改成任意字符串来冒充。正向验证是闭环的那一环。
谷歌官方也提供了可下载的 IP 段列表,但那个列表会变,实际用起来不如 DNS 验证方便。建议的做法是 DNS 验证为主,官方列表用于批量核对日志。
百度爬虫的验证方式不同,官方提供的是 IP 段加 UA 的组合判断,没有类似的 DNS 闭环机制。所以处理国内爬虫时,UA 加 IP 段是主要手段,误判率会比谷歌高一些。
第三层:行为特征
剩下的都是伪装得不错的。这时候看行为:
- 请求速率:单个 IP 一分钟请求超过几十次,且路径分散无规律,基本是采集。
- 路径模式:只抓列表页从不抓条目页,或者严格按 ID 递增顺序遍历,都不像真人。
- 静态资源:真浏览器会请求 CSS、JS、图片。只请求 HTML 的多半是脚本。
- JS 执行:在页面里放一个必须由 JS 触发的标记请求,触发了才计入统计。这一条能挡掉绝大部分简单采集器。
最后那一条其实就是 JS 统计工具天然具备的能力。这也是为什么服务器日志和统计后台的数字总是对不上——日志记所有请求,统计只记跑了 JS 的。
两份数据为什么对不上,以及该怎么用
| 数据源 | 记什么 | 适合看什么 |
|---|---|---|
| 服务器日志 | 所有 HTTP 请求 | 爬虫到底爬了哪些页、频率多少 |
| JS 统计 | 执行了脚本的访问 | 真人用户的行为和转化 |
| 搜索引擎后台 | 展示量和点击 | 搜索侧的真实表现 |
对不上是正常的,差值主要就是机器流量加屏蔽了统计脚本的用户。别试图让两份数据对齐,那是做不到也没必要的。
值得做的一件事是把日志里的爬虫流量单独统计出来,做成一个趋势图。这个数字上涨通常意味着两件事之一:你的站被更多搜索引擎关注了(好事),或者被采集器盯上了(要看是哪种)。
过滤之后该看什么
把机器流量剔掉之后,剩下才是真实的用户数据。这时候重点看的不是总量,是三个结构指标:
站内搜索使用率:多少人用了搜索框。目录站这个值通常在 10% 到 30%,低于 10% 说明搜索框没被发现或者类目够用,高于 30% 说明分类结构有问题,用户找不到才去搜。
列表页到详情页的点击率:反映了条目标题和描述的吸引力,也反映了列表排序合不合理。
单个用户的浏览条目数:低于 2 说明用户在第一个条目就离开了,可能是详情页质量或者出链体验的问题。
这三个指标加在一起,比一个虚高的 PV 数字有用得多。它们能指出具体该改哪里,而 PV 只能告诉你涨了还是跌了。