
条目表上的索引不是越多越好:目录站该怎么建复合索引
 条
条目量从几千涨到几十万的时候,最先出问题的是列表页。很多人第一反应是加索引,哪个字段慢就给哪个加一个,加到十几个索引,写入变慢,查询还是没快多少。
图片来源:网络,版权归原作者所有,侵权请联系删除
目录站的查询就那几种
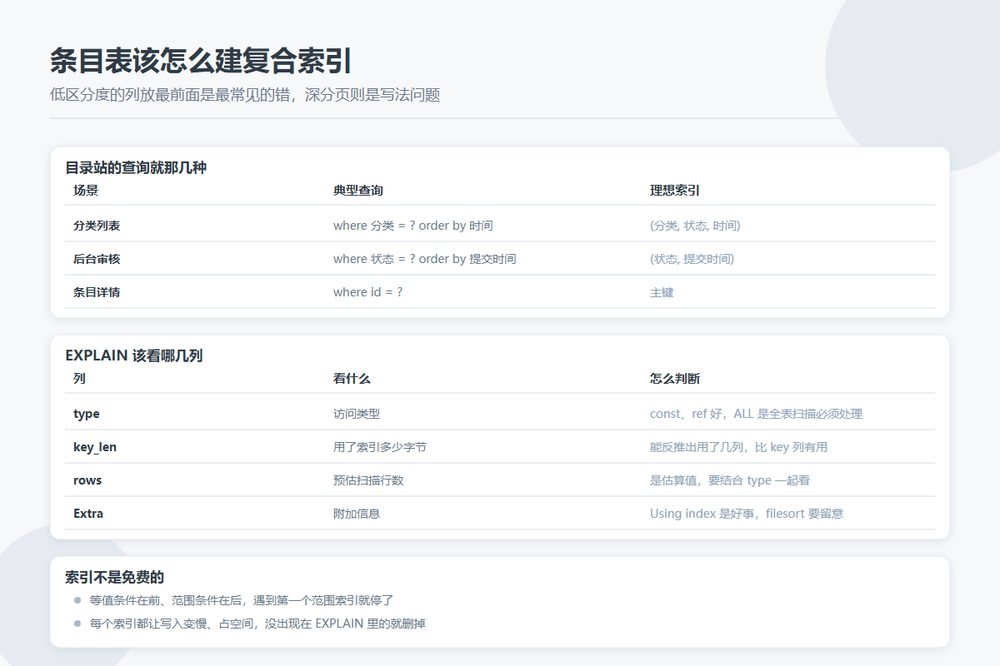
先把真实查询列出来,再谈索引。目录站翻来覆去是这四类:
| 场景 | 典型查询 | 理想索引 |
|---|---|---|
| 分类列表 | where 分类 = ? order by 时间 desc | (分类, 状态, 时间) |
| 后台审核 | where 状态 = ? order by 提交时间 | (状态, 提交时间) |
| 搜索补全 | where 站名 like 前缀 | 前缀可用普通索引 |
| 条目详情 | where id = ? | 主键 |
把这四类列出来,你会发现需要的索引远少于直觉。两三个复合索引加一个主键,基本就覆盖了。
列的顺序:等值在前,范围在后
复合索引遵循最左前缀,从左往右连续使用,跳列就断。这条规则之外,还有一条更实用的:等值条件的列放前面,范围条件的列放后面。因为索引遇到第一个范围条件就停了,后面的列只能当过滤用,不能再用来定位和排序。
拿分类列表举例。分类是等值,状态是等值,时间一般是范围或者排序,所以顺序是分类、状态、时间。写成 (时间, 分类) 就尴尬了:时间一上来就是范围,分类那一列根本用不上。
低区分度的列放最前面是另一个常见错误。状态这种只有几个取值的列,单独放最前面,索引第一层就把数据分成几大坨,后面的列再精确也快不了。区分度高的列优先,除非查询模式另有要求。
排序和分组接在过滤列后面
索引是有序的。如果排序字段刚好接在等值过滤列之后,数据库可以直接顺着索引读出来,不用额外排序。这就是很多列表页加了索引之后从几百毫秒降到几毫秒的原因——省掉的不是扫描,是排序那一步。
判断方法看 EXPLAIN 的 Extra 那一列。出现 Using filesort 就说明排序没走索引,要么调整索引列顺序,要么接受它(数据量小的时候 filesort 并不慢,别过度优化)。
覆盖索引值不值
如果索引里包含了查询需要的全部字段,数据库就不用再回表取数据,这一步叫覆盖索引,EXPLAIN 里显示为 Using index。列表页只取站名、链接、简介这几个字段时,把它们一起放进索引,收益很明显。
代价是索引变大。把整条简介塞进索引是不划算的,简介几百字,索引会被撑到跟表差不多大。折中做法是索引里只放列表需要的短字段,详情页需要的长字段照常回表——详情页是单条查询,回表一次的成本可以忽略。
EXPLAIN 该看哪几列
- type:从好到差大致是 const、ref、range、index、ALL。看到 ALL 就是全表扫描,必须处理。
- key_len:实际用了索引的多少字节。这个值能反推出用了几列,比看 key 列有用得多。三列索引只用了第一列,key_len 就会明显偏小。
- rows:预估要扫描的行数。这个数是估算,别拿两行 EXPLAIN 的 rows 直接比大小来判定索引好坏,要结合 type 一起看。
- Extra:Using filesort 和 Using temporary 是重点,Using index 是好事。
深分页是另一回事
翻到第一百页很慢,不是索引的问题,是写法的问题。limit 一个大偏移量,数据库得先数过前面那些行再扔掉。解决思路是改成记住上一页最后一条的时间或 id,用 where 时间小于某个值接着取,而不是 offset。这一改,索引才能真正帮上忙。
索引不是免费的
每个索引都会让写入变慢,占空间,还影响备份体积。目录站条目更新频繁,索引堆到十几个,审核一次存一次就要维护十几个 B 树。定期用 SHOW INDEX 看一遍,把从来没出现在 EXPLAIN 里的索引删掉——它们只在账单上存在。