
一台机器挂了整站就 502:目录站的双机热备和故障切换,以及切换那几分钟爬虫会看到什么
 一
目录站的可用性问题常被低估。它不像电商那样有直接的交易损失,但一次几小时的 502,带来的后果是搜索引擎把整站的抓取频率调下来,之后要几天才恢复。对靠新条目收录吃饭的目录站,这几天是实打实的损失。
图片来源:网络,版权归原作者所有,侵权请联系删除
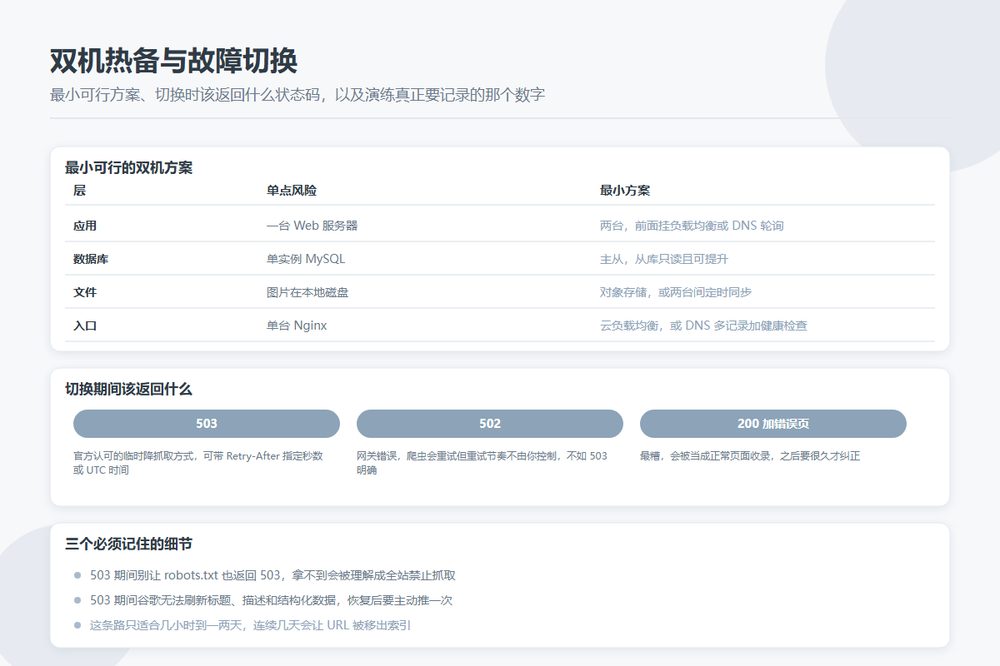
最小可行的双机方案
| 层 | 单点风险 | 最小方案 |
|---|---|---|
| 应用 | 一台 Web 服务器 | 两台,前面挂负载均衡或 DNS 轮询 |
| 数据库 | 单实例 MySQL | 主从,从库只读且可提升 |
| 文件 | 图片在本地磁盘 | 对象存储,或两台间定时同步 |
| 入口 | 单台 Nginx | 云负载均衡,或 DNS 多记录加健康检查 |
对大多数目录站,做到前两层就够了。真正的单点往往是数据库:Web 服务器挂了可以重启,数据库挂了或者数据盘坏了,恢复时间要以小时计。
MySQL 主从的部署成本现在不高,云厂商都有现成方案。要注意的是从库不是备份,主库上一条误删会同步到从库。备份是另一件事,前面专门写过。
切换那几分钟,爬虫看到什么
这是本文的重点。故障发生到切换完成之间,站点会有一段时间不可用。这段时间返回什么状态码,直接决定后续影响的大小。
返回 503,不要返回 502,更不要返回 200 加一个错误页。502 是网关错误,爬虫会当成服务端问题重试,但重试节奏不由你控制。200 加错误页最糟,它会被当成正常页面收录,之后要花很久才会纠正。
谷歌官方文档里对紧急降抓取频率的做法有明确说明:需要临时(几小时到一两天)降低抓取压力时,返回 500、503 或 429 而不是 200,并且可以带 Retry-After 头告诉爬虫多久之后再来。这个头支持秒数,也支持一个绝对的 UTC 时间。
同时文档里有一条警告必须记住:这条路只适合短时间内使用。如果爬虫连续几天在同一批 URL 上看到这些状态码,这些 URL 有可能被移出索引。所以 503 是应急,不是常态。
还有两个细节
第一,503 期间别把 robots.txt 也一起返回 503。robots.txt 拿不到会被理解成全站禁止抓取,影响范围比故障本身大得多。静态托管一份 robots.txt,或者让它始终由负载均衡层直接返回。
第二,503 期间谷歌无法刷新页面的标题、描述、元数据和结构化数据。所以如果故障期间正好有一批条目要上线,切换完成之后要主动推一次,别等自然抓取。
数据一致性的取舍
主从复制有延迟,正常情况毫秒级,大批量写入时可能到秒级。目录站的问题场景是:用户在 A 机提交了条目,读请求落到 B 机,从库还没同步,用户看不到自己刚提交的内容。
三种处理方式:读主库(简单,主库压力大);写后短期读主(提交后 5 秒内读主库,其余读从库);接受延迟并在界面上说明「提交后需要几分钟审核」。
第三种对目录站其实很合适。条目提交本来就要人工审核,界面上写清楚有审核环节,用户不会期待立刻看到。这比为了一致性把架构复杂化划算得多。
切换要不要自动
自动切换听起来好,但对小团队有风险:网络抖动触发误切换,主库被降为从库,数据要重新对齐,这个恢复过程比原故障更麻烦。
折中方案:数据库层面用云厂商的托管服务(它自带自动故障转移和一致性保证),应用层用健康检查加自动摘除,但主库切换留给人工确认。这样日常的单台 Web 故障能自动扛过去,真正严重的情况才需要人介入。
演练怎么做
没有演练过的切换方案等于没有方案。每季度做一次,流程很简单:
选一个低峰时段,手动停掉一台 Web 服务器,观察另一台是否接管、监控是否告警、页面是否正常;然后停掉从库观察读请求的表现;最后记录每个环节的耗时。
演练真正的产出不是「能不能切」,是那份耗时记录。切换用了 4 分钟还是 40 分钟,决定了故障时的损失量级。把这份记录放在文档里,下次故障时不用现算。
另外记得在演练期间把监控告警临时静音,或者在内部群里先说一声。演练触发告警又没人处理,次数多了大家会开始忽略告警,这个副作用比演练本身的价值还大。