
把目录导出成书签、OPML、CSV:下载与导出页怎么做
 把
用户用目录站的方式比想象中多样。有人就想一键把某个分类的几十个站点导到浏览器书签栏里,有人想把整个目录的 RSS 订阅导进阅读器,还有人是开发者,想要一份结构化数据自己分析。
这三种需求对应的格式不一样,做法也不一样,但都可以靠同一类页面解决:导出页。
图片来源:网络,版权归原作者所有,侵权请联系删除
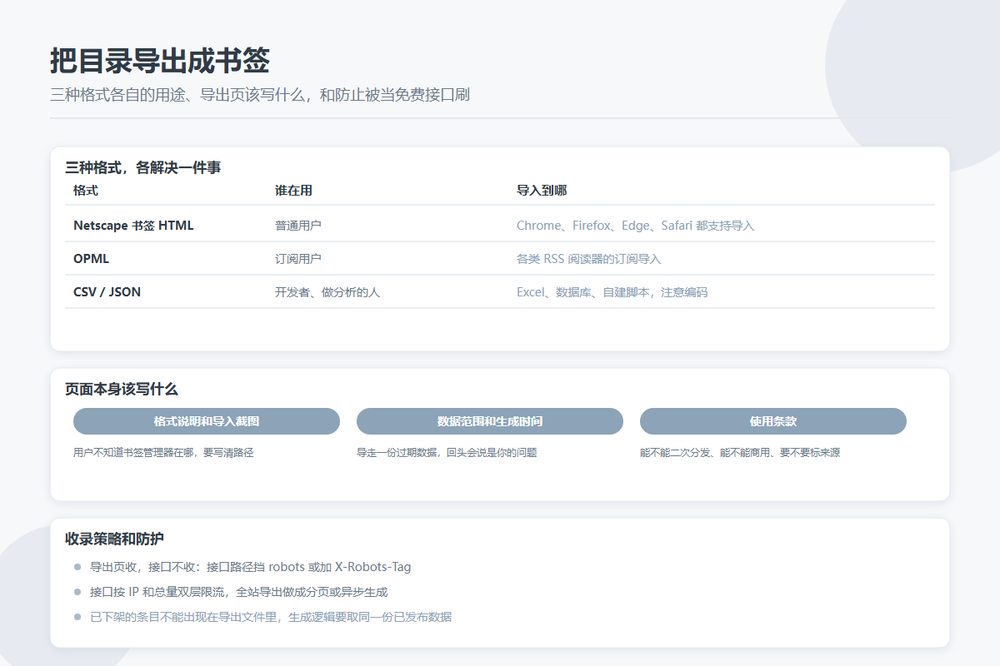
三种格式,各解决一件事
| 格式 | 谁在用 | 导入到哪 |
|---|---|---|
| Netscape 书签 HTML | 普通用户 | Chrome、Firefox、Edge、Safari 的书签管理器都支持导入这种格式 |
| OPML | 订阅用户 | 各类 RSS 阅读器的订阅导入 |
| CSV / JSON | 开发者、做分析的人 | Excel、数据库、自建脚本 |
书签格式是最容易做出效果的一个。它是个很老的格式,正因如此所有浏览器都认。结构上就是嵌套的 <DL><DT><A>,把分类当文件夹、条目当书签,几十行代码就能生成。导出的文件名用 bookmarks.html,用户一看就知道怎么用。
OPML 是给订阅场景的,适合你的条目上有 RSS 源、或者你把分类做成订阅列表的情况。它本质是 XML,每个 <outline> 带 text、htmlUrl、xmlUrl 几个属性。没有 RSS 源的目录站做这个意义不大。
CSV 和 JSON 是给开发者的。字段要定清楚并写在页面上:站点名、网址、简介、分类、收录时间、最后更新时间、标签。编码统一 UTF-8,CSV 建议带 BOM,否则 Windows 上用 Excel 打开是乱码,这一条不加会收到一堆反馈。
页面本身该写什么
一个空荡荡的"点击下载"按钮是不够的。导出页上该有:
- 每种格式是什么、适合谁、导进去之后长什么样。配一张导入后的截图,比写三段文字有用
- 导入步骤。用户不知道浏览器的书签管理器在哪,写清楚"书签管理器 → 导入和备份 → 导入 HTML"
- 数据范围和时间点。导出的是哪个范围、包含多少条、生成于什么时间
- 更新频率。是每天生成还是实时生成,实时的话有没有缓存
- 使用条款。能不能二次分发、能不能商用、需不需要标注来源
最后一条别省。你的目录是花时间攒的,写清楚边界,真出现整站搬运的时候你有依据。
收录策略:页面收,接口不收
导出页本身值得被收录。它对应的是真实长尾需求,"把导航站导入浏览器书签""网站收藏夹批量导入"这类词有人搜,而且搜的人正好是目录站的目标用户。
但真正生成文件的那个接口地址不要进索引。它是动态的、每次请求都要生成文件、返回的是附件,被抓没有任何意义,还占抓取预算。处理方式:在 robots.txt 里挡掉导出接口路径,或者在接口响应上加 X-Robots-Tag: noindex。
同时这个接口要限流。它是全站最容易变成免费 API 的入口:一次请求就能拉走几千条数据,写个循环就能把整个目录搬走。限流按 IP 加按总量双层,单个 IP 每分钟几次、每天多少次,超了返回明确的状态码。
大范围导出(比如全站几千条)不要做成同步请求,会拖垮服务器。做成分页导出,或者提交后异步生成、好了给个下载链接。
顺带能拿到的东西
导出页有个副作用是正向的:它容易被引用。写"书签管理""导航整理""收藏夹备份"这类内容的人,需要给出可导入的示例,你的导出页正好是那个示例。这类引用带来的外链质量通常不错,因为引用者是内容创作者而不是互换链接的人。
要让这件事发生,页面得足够清楚。别把导出藏在一个需要登录的入口后面,也别只给一个不带说明的下载按钮。
三个要注意的坑
导出的是过期数据。如果导出文件是定时生成的,页面上要标生成时间。用户导走一份三个月前的数据,回过头来说是你的问题。
导出内容里要把来源织进去。书签 HTML 里可以加一个指向你站点的文件夹或条目说明,CSV 里保留一列来源地址。数据被搬走之后,这是唯一还能指向你的东西。
别让导出成为下架条目的后门。已经下架的违规条目,如果还在导出文件里,等于你的下架没生效。导出生成逻辑必须走和前台同一份已发布数据,不能从原始库直接取。
导出页做起来成本不高,一个页面加三个生成脚本。它是那种"做了不会立刻见效,但三五年一直在给你带来入口和外链"的东西。