
列表翻到第 1000 页会怎样:游标分页、排序稳定,和深分页的三个替代
 列
偏移分页的问题要分两层看。
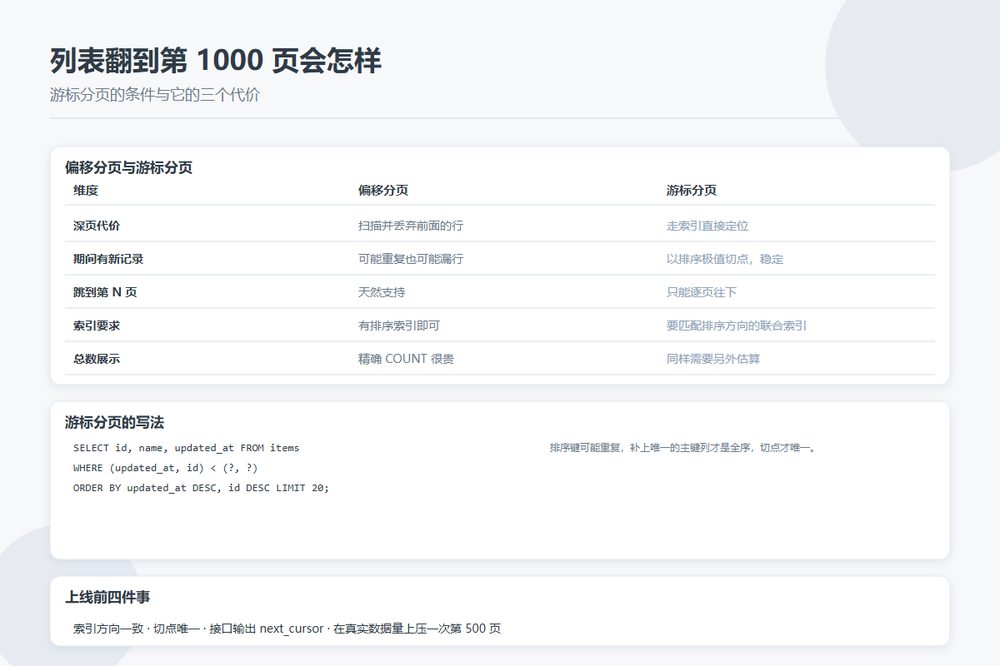
第一层是代价:OFFSET 不是跳过去的,是走过去的。数据库要把前面的行一条条扫描、排序、跳过,然后才返回你要的这一页。第 1000 页意味着走过了两万行。它还会把这份不确定传给爬虫——响应越慢,抓取越少。
第二层是正确,这一层更隐蔽。而在你读到第十二页和第二十页之间,只要有一条新记录加进来,就会出现:
| 插入位置 | 用户看到什么 |
|---|---|
| 当前页之前 | 翻到下一页时重复看到一条 |
| 当前页之后 | 什么也感知不到 |
| 删除了一条 | 某条记录被静默跳过,永远不出现 |
目录站因为一直在提交新条目,这个现象会常态化:用户投诉「翻的时候重复了」,客服还复现不出来。
图片来源:网络,版权归原作者所有,侵权请联系删除
游标分页的思路
不再说「我要第几页」,而是说「我要排在某某之后的二十条」。条件直接变成可以走索引的范围查询:
SELECT id, name, updated_at
  FROM items
 WHERE (updated_at, id) < (?, ?)
 ORDER BY updated_at DESC, id DESC
LIMIT 20;为什么是二元组?因为排序键可能重复。如果只按 updated_at 切,同一毫秒更新的条目会被切成两半,边界上的记录可能漏掉也可能重复。补一个唯一列(通常是主键)参与排序,顺序才真正全序,切点才唯一。
代价也要写清楚:这条路必须依赖一个能覆盖排序方向的索引(这里是 (updated_at DESC, id DESC) 的联合索引),否则能还不如偏移分页。而且它天然不支持「直接跳到第 50 页」——翻页只能一页页往下。
三种可以配合使用的替代
限制可见深度
绝大多数用户根本不会翻到第 100 页。与其优化深分页,不如把列表的深度本身收住:给足筛选条件(分类、地区、核验状态、时间),让每一趟查询的结果集变小。分页慢的根因是结果太大,不仅仅是分页方式。
总数改成估算
「共 12,345 条」这个数字往往是最贵的那次查询。精确 COUNT 在有过滤条件的大表上等同全量计数。三种退让:用估算值( PostgreSQL 的规划器估算或 MySQL 的行数估算)、维护一张计数表按需更新、或者直接写「约 1.2 万条」。用户几乎不会核对这个数字。
上一页与下一页
游标分页往上翻需要反向条件:(updated_at, id) > (?, ?) 配合升序排序再倒过来展示。实现上多一步,但保留了游标的所有好处。
和 SEO 的关系
这一块要和分页收录策略分清:这篇讲的是数据库和接口层的能,与「要不要让爬虫翻到深处」是两回事。
但两者有个交叉点值得留意:如果因为深分页慢,导致爬虫在第 30 页附近遇到超时或被限流,那么「分页出来的条目就不会被正常抓到」这个问题会先以超时的形式暴露出来。先保证 HTML 列表页每一页的响应时间可控,再讨论要不要让它被索引。
另外一个常被问的点:如果需要把已有的 offset 分页改成游标分页,URL 里的 page 参数要怎么处理?建议保留旧参数做兼容:?page=N 仍然可用,内部换算成游标(或退化为偏移),新的翻页链接则输出游标形式,逐步迁移。别一次性切换,那会让已经进入索引的和别人引来的旧地址全部失效。
上线前的四件事
一,确认排序组合有对应索引,且索引方向和 ORDER BY 一致。二,确认排序键 + 主键的组合可以唯一切点(有 null 值时要额外处理排序方向)。三,接口输出 next_cursor 而不是页码,避免客户端自己去拼。四,在真实数据量上压一次第 500 页的响应时间,别信开发环境。