
表涨到几百万行之后:分区、归档,和那些越跑越慢的查询
 表
分区不是一个加速按钮。它解决的是另外三件事:历史数据能整块退场、查询能只扫相关分片、表太大时的维护操作不再动辄全表。如果你的问题只是某个查询慢,先去优化索引和 SQL,分区解决不了扫描了不该扫的东西。
图片来源:网络,版权归原作者所有,侵权请联系删除
先看哪些表值得动
| 代表表 | 增长方式 | 特点 |
|---|---|---|
| 抓取日志 | 每天数千至数万 | 几乎只按时间查 |
| 出站点击流水 | 随流量线涨 | 按时间与条目查 |
| 条目变更历史 | 随编辑量增长 | 回看为主 |
| 条目主表 | 缓慢 | 通常不该分区 |
判断口径很简单:这张表的主查询条件是不是稳定地落在某一个维度上(通常是时间)。是,分区有用;不是,分区只增加运维复杂度。
MySQL 那条绕不过去的规则
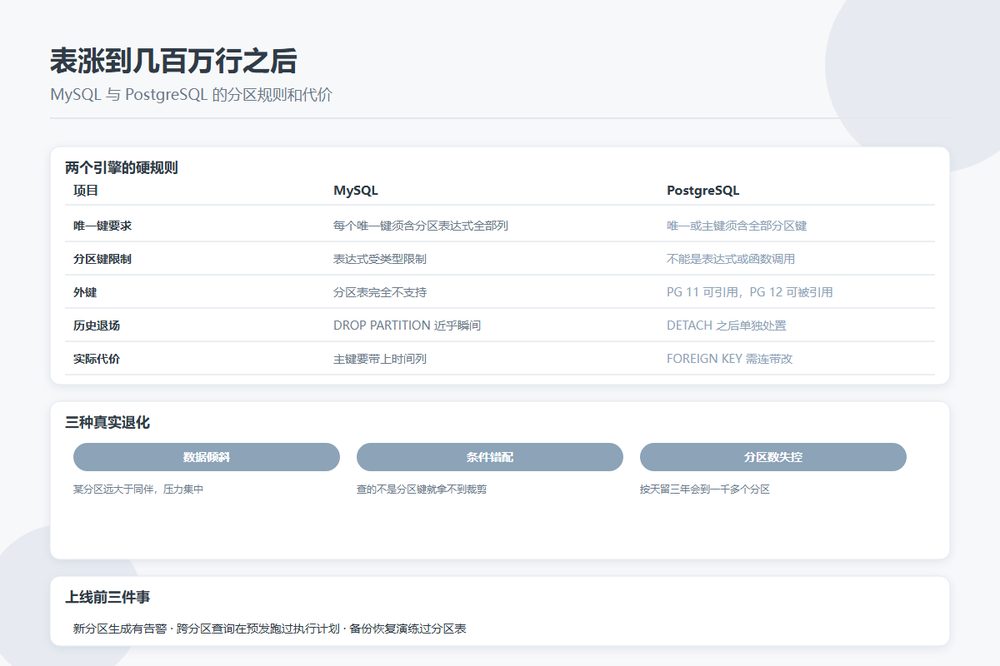
MySQL 的要求写得很硬:表上的每个唯一键,包括主键,都必须包含分区表达式用到的所有列。这不是文档笔误,原因是分区表的索引都是每个分区本地的,本地索引只能在自己分区内保证唯一,跨分区重复谁也看不见。
因此按 created_at 做范围分区,就意味着 created_at 必须进主键。后果比想象中大:主键从 (id) 变成 (id, created_at),所有外键引用、下游同步逻辑、ORM 映射都要跟着改。
还有一条常被遗忘的硬约束:分区的 InnoDB 表不能有外键,既不能引用别人,也不能被别人引用。这基本决定了 MySQL 里分区只适合那种「和主模型关系简单」的事实流水表。
作为补偿,换来的是删除的速度:按月的 RANGE 分区,退掉一个月就是一条 DROP PARTITION,几乎瞬间完成;换成 DELETE 删几百万行,要写 undo、要 purge、还要留下一堆碎片。
PostgreSQL 这边
PostgreSQL 的声明式分区从 10 起支持,规则同源但表述略不同:唯一约束或主键必须包含所有分区键列,且分区键里不能有表达式或函数调用。
外键的处境比 MySQL 宽松得多:11 起分区表可以引用别的表,12 起可以被别的表引用。也就是说 PostgreSQL 里「分区 + 参照完整」是可以共存的。
另外它的分区就是普通表,可以单独建索引、单独设 autovacuum 参数,还能 ATTACH / DETACH 做生命周期管理。归档时把某个月份 DETACH 出来单独处置,比删数据温和得多。
三种真实退化
条件没命中分区键
比如按 item_id 查,而表是按 created_at 分区的。这时规划器要挨个分区走本地索引再合并结果,成本和一张大表没什么两样——不算变慢,但你期待的分片收益一分钱都拿不到。
分区键选错导致倾斜
某个促销月、某个热点事件的分区远大于其他分区,IO、锁、vacuum 压力全都集中过去,等于把原来的热点缩小了一圈继续存在。定期检查各分区的实际行数。
分区数失控
按天分区留三年就是一千多个分区,DDL、规划时间、打开文件数都会受影响。大多数业务按月已经够用。
如果还不到分区的时候
三件事做了往往就不必分区:
第一,冷热分离。把超过某个时间的数据搬到同结构的归档表(或另一套存储),主表保持在可控体量。这一步的收益和分区接近,代价小得多。
第二,专业化组合索引。时间范围查询要配上匹配实际排序列的联合索引,比分区更能直接减少扫描。
第三,别查总数。列表页那个「共 N 条」往往是慢查询第一名,改成估算或从计数表读。
真要分区,先把维护自动化
提前创建未来分区、到期自动 DETACH 或 DROP,这两件事必须一开始就有脚本。手工创建分区的业务,最终都会在某个月初因为没人执行而出错。
最后别忘了上线前必须过的三件事:新分区的生成任务有告警;跨分区查询在预发环境已经跑过一遍执行计划;以及备份恢复流程确认过「分区表的恢复」能真的恢复到可用状态。