
Redis 里的 big key 和热 key:目录站缓存的数据结构该怎么挑
 R
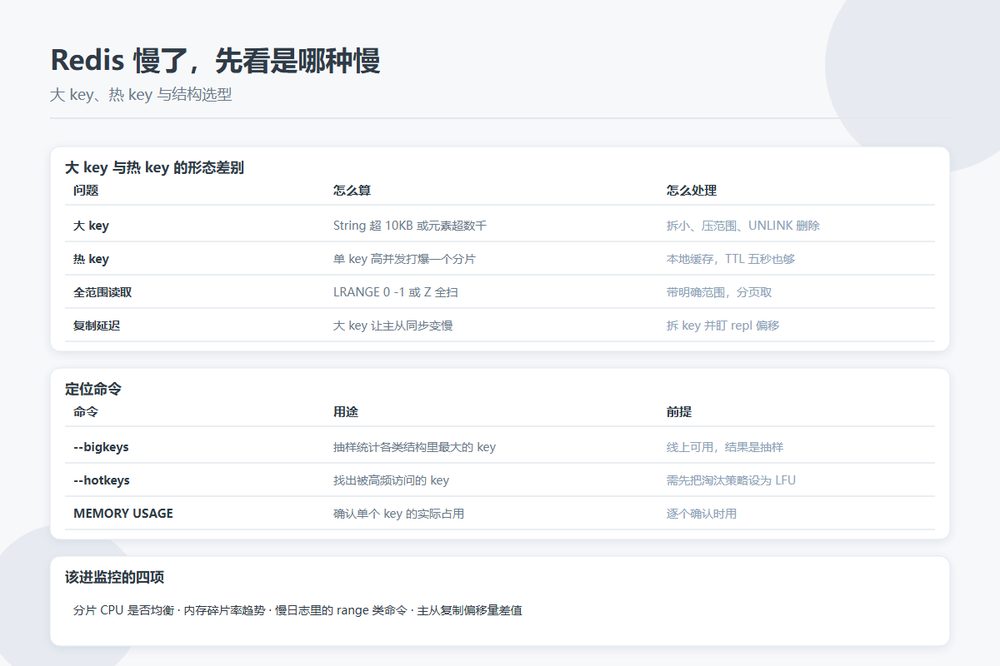
先把两个词定义清楚——阈值本身是行业惯例而不是官方标准。big key 通常指 String 超过 10KB、或集合元素超过几千个的 key;hot key 指被极高并发访问的单个 key。不同团队的具体数字会有出入,但判断逻辑一致:看它对单线程模型和单分片造成了什么影响。
图片来源:网络,版权归原作者所有,侵权请联系删除
大 key 到底伤在哪
Redis 处理命令是单线程的,一个几十 KB 的 String 做序列化、网络分包,占用的时间会挡住后面所有命令。它的影响还往下传:主从同步时大 key 让复制延迟上升,AOF 重写时文件膨胀,DEL 删除时可能直接卡住。
顺带说个常见误解:集群模式救不了大 key。一个 key 永远只属于一个分片,把它拆成十个小 key 之后分片才有意义,在此之前扩容只是把同一个问题搬到更大的机器上。
定位的三条命令
| 命令 | 看什么 | 备注 |
|---|---|---|
| redis-cli --bigkeys | 抽样统计各类结构里最大的 key | 线上可用,结果是抽样 |
| redis-cli --hotkeys | 热 key | 需要先把淘汰策略设为 LFU |
| MEMORY USAGE <key> | 单个 key 的实际占用 | 确认单个对象用 |
再加两件日常就该做的事:打开慢日志,重点看 HGETALL、LRANGE、SMEMBERS、各类 SCAN;以及确认线上没有 KEYS 命令在运行——要遍历键空间一律用 SCAN。
结构选型:目录站常见四种场景
| 场景 | 别这么写 | 推荐写法 |
|---|---|---|
| 单个条目详情 | 一个 String 存整页 HTML | Hash 存字段,按需取 |
| 分类列表 | 几万条塞进一个 List | 按页拆分 + ZSet 排序 |
| 热度榜 | 每次全量重算 | ZSet 增量更新 |
| 整站配置 | 一个大 key 全塞进去 | 拆成多个小 key |
目录站特别容易踩的是第一条:整页 HTML 缓存。页面几十上百 KB,模板一改全线失效,且永远不能部分更新。改成按字段存的 Hash,条目换 logo 只需要更新一个字段。
另一条是关于范围写法:别对整个集合做全范围读取,ZREVRANGE、LRANGE 都要带上明确范围。热榜取前 50 就够了,别写 0 到 -1。
热 key 的解法只有两条路
第一,本地缓存。官方文档给的建议很直接:如果热 key 的读取是只读的,在应用层加一层本地缓存,哪怕 TTL 只有五秒,热 key 问题基本就消失了。这条路代价最小,也应该第一个试。
第二,打散。key 名后缀一到 N 个随机分片,读写时随机挑一个,把压力摊到不同槽位。代价是失效时要逐个删,且读到的数据要多取几份合并。通常是在已经用了集群、且某个分片 CPU 明显偏高时才用。
顺便补一个常被忽略的前提:每个 key 只属于一个分片,所以热 key 的 CPU 问题永远表现为「某一个分片特别忙」。如果你看到的是所有分片都忙,那多半不是热 key,是整体容量不够。
删除:用 UNLINK 而不是 DEL
大 key 的同步释放会阻塞实例。UNLINK 把释放动作交给后台线程,这是当天就能改的一条。另外可以设置 lazyfree 相关参数(如 lazyfree-lazy-user-del),让普通的 DEL 也走异步。
该写进监控的四项
一,分片的 CPU 是否均衡——不均衡基本就是热 key 信号。二,内存碎片率趋势。三,慢日志里 range 类命令的出现频率。四,主从复制偏移量的差值,也就是实际的复制延迟。
把这些做成看板之后,绝大多数问题会在变成故障之前出现迹象。真正危险的是那类「一直在慢慢变坏」的用法:没人写错代码,只是每天往同一个 key 里多塞一点。