
条目数据被竞品整站扒走:识别、防采集的限度,和不正当竞争那条线
 条
目录站的核心资产不是程序,是那几万条人工核过的数据。所以你的站一旦做出名气,被同行整站扒数据几乎是必然的:一个晚上,几千个条目连图带简介出现在别人的站上,分类结构都懒得改。
图片来源:网络,版权归原作者所有,侵权请联系删除
先取证,再谈其他
发现被扒,第一件事不是改代码加防,是固定证据:对抄袭页面做公证或可信时间戳存证,记下对方站的页面、你的原始发布时间、双方数据的对应关系。你的发布时间早于对方,是你主张权利的地基,而发布时间是随时可查的——前提是你自己的数据带时间戳。
技术防采集,认清它的限度
常见的手段都可以上,但要明白它们只能抬高成本,挡不住真想扒的人:频控加 UA 校验能挡掉九成低级脚本;蜜罐条目——在某几个条目里埋进独特的错别字或虚构数据,谁原样抄走,就是一击即中的证据;登录墙和延迟加载防得更彻底,但也把搜索引擎和真实用户一起劝退。
这个取舍各站自己定。只想说一句:为了防采集把页面做成搜索引擎看不懂的样子,是拿确定的收录去换不确定的防线,这买卖不划算。
法律那条线:robots 协议挡不住的,反不正当竞争管
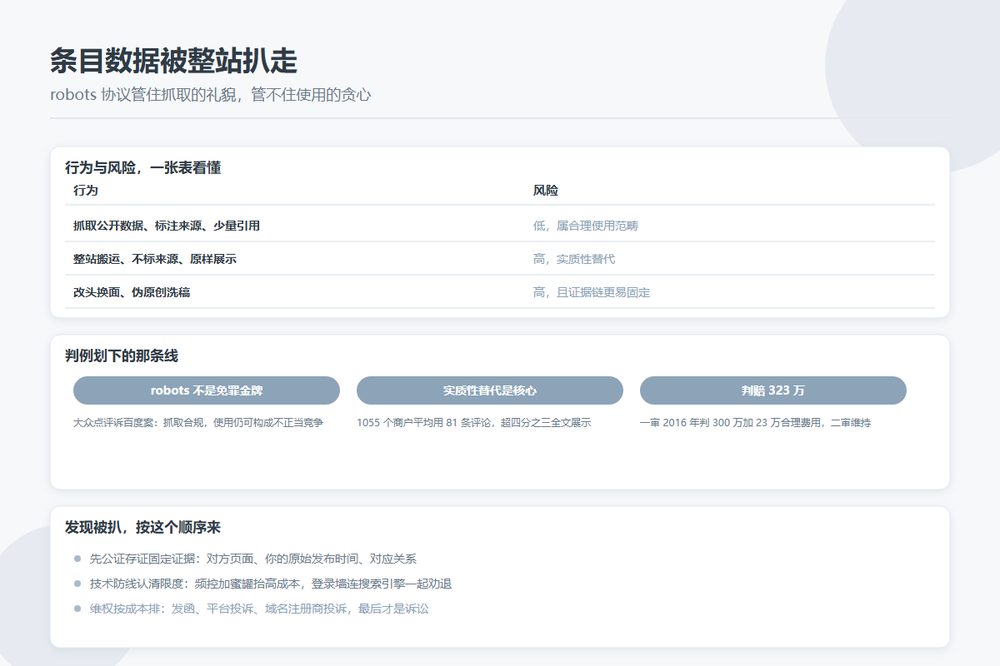
很多人以为对方「遵守了我的 robots」或「robots 没禁止就随便爬」。判例不是这么说的。大众点评诉百度案里,百度抓取行为符合大众点评的 robots 协议,法院照样认定不正当竞争——上海浦东法院 2016 年一审、上海知识产权法院 2017 年二审维持,判赔经济损失 300 万元加合理费用 23 万元。
判决的逻辑核心是「实质性替代」:公证抽查显示百度地图里 1055 个商户平均每家用了 81 条来自大众点评的评论,大量商户页面上四分之三以上的评论来自大众点评且全文展示。法院的态度翻译成大白话就是:robots 协议解决的是「能不能来抓」,抓来的信息怎么用、用到什么程度,还要过商业道德这一关。大量全文使用、替代原站向用户提供内容,就越过了这条线。
| 行为 | 风险 |
|---|---|
| 抓取公开数据、标注来源、少量引用 | 低,属合理使用范畴 |
| 整站搬运、不标来源、原样展示 | 高,实质性替代 |
| 抄袭后改头换面、伪原创洗稿 | 高,且证据链更易固定 |
robots 协议是君子协定,不是免罪金牌。它管住的是抓取的礼貌,管不住使用的贪心。
维权路径按成本排:先发函要求下架(很多扒数据的站主收到函就怂了),再走平台投诉和域名注册商投诉,最后才是诉讼。判例摆在那里,你的胜算取决于证据链,而证据链取决于你被扒之前有没有把时间戳和存证习惯养好。