
列表页为什么越改越慢:目录站的 N+1 查询和 ORM 懒加载
 列
列表页是目录站的门面,也是最容易被 N+1 拖垮的地方。一个条目卡片上通常要显示分类名、标签、缩略图地址、最近核对时间——这些数据大多存在关联的表里。
问题出在写法上。看起来很自然的一段代码:
items = Item.query.filter_by(cate_id=108).limit(50).all()   # 第 1 次
for it in items:
    print(it.category.name)      # 每行再来 1 次
    print(", ".join(t.name for t in it.tags))   # 每行再来 1 次
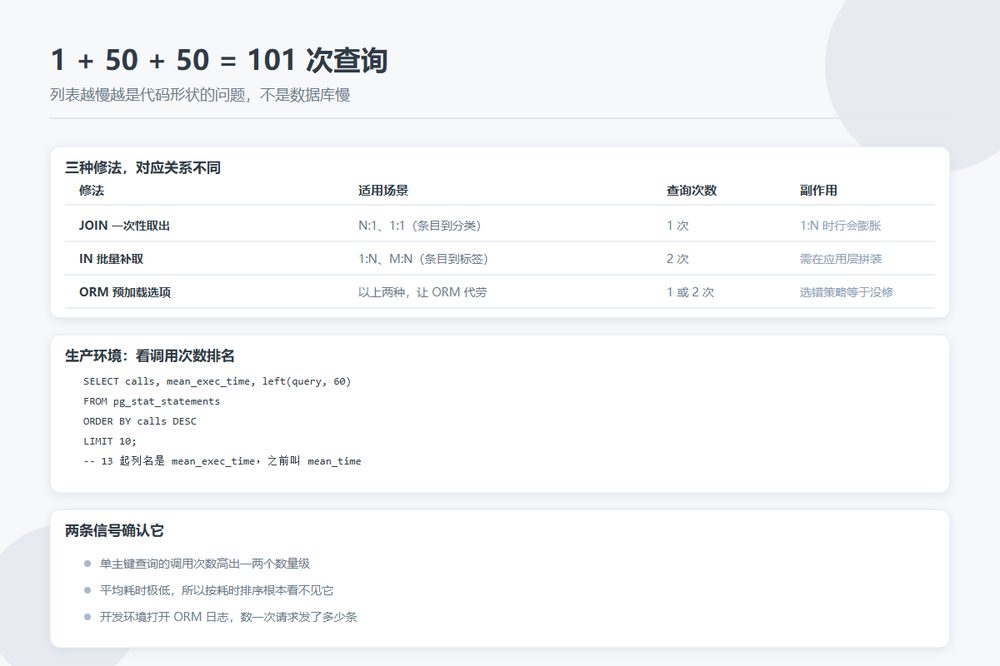
50 条数据的列表,加上分类和标签各一次,实际查询次数是 1 + 50 + 50 = 101 次。每条查询只要一两毫秒,开发环境十条数据完全看不出来。等线上数据量涨到几千、并发上来,连接数和往返次数一起翻番,页面就慢了。
图片来源:网络,版权归原作者所有,侵权请联系删除
根因不是 ORM,是代码形状
ORM 的关系字段通常默认懒加载:访问 it.category 的那一刻才发一条 SELECT。代码里看不到 query,但运行时确实发了。
值得强调的是,这不是 ORM 的缺陷。手写的 SQL 只要写成「先查列表,再在循环里按 id 查关联」,问题一模一样。真正的触发条件是这个代码形状:遍历一个集合,同时在循环体里访问关系字段。
顺便说一句,这也是为什么 AI 生成的代码特别容易带 N+1——它写的是局部正确、风格地道的写法,看不到数据库那层的实际执行次数。
两条信号确认它
生产环境:看调用次数排名
PostgreSQL 的 pg_stat_statements 是最准的来源。N+1 的特征非常明显:单条按主键查询的语句,调用次数比其他查询高出一两个数量级,而平均耗时极低。
SELECT calls, round(mean_exec_time::numeric, 2) AS mean_ms,
       left(query, 60) AS query
FROM pg_stat_statements
ORDER BY calls DESC
LIMIT 10;
注意 PostgreSQL 13 之前这一列叫 mean_time,13 起改名为 mean_exec_time。
关键判断是「查询形状 + 调用次数」的组合:SELECT * FROM category WHERE id = $1 这种单主键查询,如果调用次数随着页面上的行数同步增长,基本可以确认。单纯调用次数高不算证据,很多正常的热点查询也是高频的。
开发环境:数每个请求的查询数
打开 ORM 的 SQL 日志,加载一次页面,数一下发了多少条。Django 开 django.db.backends 的 DEBUG 日志,SQLAlchemy 用 echo=True 或者给 sqlalchemy.engine 设 INFO 级别。
如果日志里同一条语句带着不同的 id 重复出现几十上百次,那就是它了。Python 有 nplusone 这类库能在开发阶段自动检测,Rails 有 bullet,Java 侧可以看 Hibernate 的统计。
更进一步的做法是给每个请求设一个查询数上限,写进测试里。这条防线能在后续重构时机械地拦住复发的 N+1。
三种修法,对应关系不同
| 修法 | 适用场景 | 查询次数 | 副作用 |
|---|---|---|---|
| JOIN 一次性取出 | N:1、1:1(条目 → 分类) | 1 次 | 1:N 时行会膨胀 |
| IN 批量补取 | 1:N、M:N(条目 → 标签) | 2 次 | 需要在应用层拼装 |
| ORM 预加载选项 | 以上两种,让 ORM 代劳 | 1 或 2 次 | 选错策略等于没修 |
配对规则很实用:N:1 的关系用 JOIN 形状,1:N 的集合用 IN 形状。理由是 JOIN 一个集合会让结果行成倍膨胀——50 个条目每个 5 个标签,JOIN 出来是 250 行,条目字段重复 5 遍。
各框架的对应写法:
- Django:外键用
select_related("category")(走 JOIN);多对多和反向外键用prefetch_related("tags")(走第二条 IN 查询)。 - SQLAlchemy:
joinedload()对应 JOIN 形状,selectinload()对应 IN 形状。 - Rails:
includes(:category)。
还有一个场景值得单独提:GraphQL 或者结构不确定的接口,预加载不好用,这时候上 DataLoader 模式——把一个操作周期内请求的所有 id 攒起来,最后一次性批量查。
目录下典型的四个 N+1 位置
列表页卡片上的分类名和标签,这是第一位。缩略图地址如果单独存一张表,同理。
「相关条目」和「相似站点」模块,如果每条卡片都要算一次相似度或者查一次关联表,直接翻倍。
面包屑。很多实现是逐级往上查父分类,三层分类就是三次查询,而且每条都懒加载。
后台的审核列表最容易漏——运营要看的字段多,一个页面几十次关联查询很常见,只是因为并发低没人抱怨。
修完之后的下一步
N+1 清干净之后,如果还有「调用次数正常但就是慢」的问题,那就是另一个家族了:单次查询慢。这时候该看执行计划和索引,而不是继续数查询次数。
给目录站的建议是先在列表页上做一遍查询数清点,这个投入产出比通常比调索引更高——它不需要理解业务,只需要数数。