
数据被别人整站抓走了:目录站开放 API 的边界该怎么划
 数
目录站的数据是整理出来的,不是生成的,所以它对别人的价值比对搜索引擎的价值还直接。被抓是迟早的事,问题不是能不能杜绝,而是要把这件事控制在什么范围内。
图片来源:网络,版权归原作者所有,侵权请联系删除
先想清楚:你要的是"被引用"还是"被复制"
这两种结果天差地别。被引用意味着对方标了来源、用户会顺着链接回来;被复制意味着用户根本不知道数据是从你这来的。技术上的防线只能减少后者,前者要靠授权条款和来源标注来争取。
所以动手之前先定策略:允许什么、要什么回报、超出的部分怎么处理。
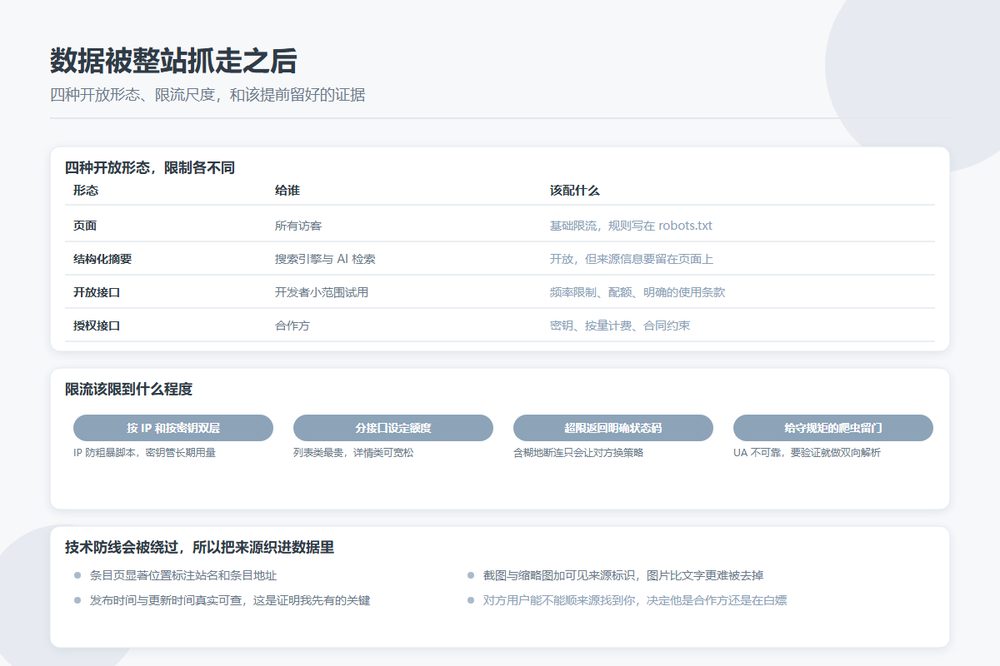
四种开放形态,限制各不同
| 形态 | 给谁 | 该配什么 |
|---|---|---|
| 页面(给人看) | 所有访客 | 基础限流,规则写在 robots.txt |
| 结构化摘要 | 搜索引擎、AI 检索 | 开放,但要保证来源信息在页面上 |
| 开放接口(无需申请) | 开发者小范围试用 | 频率限制、配额、明确的使用条款 |
| 授权接口 | 合作方 | 密钥、按量计费、合同约束 |
最常见的错误是把第三层和第四层混在一起:做了一个无需申请的接口,又指望对方守规矩。没有密钥就没有身份,没有身份就没法追责。
限流该限到什么程度
限流的目标不是拦住所有人,是让"整站搬运"这件事的成本高到不值得做。几个可参考的尺度:
- 按 IP 和按密钥双层。IP 层防的是粗暴脚本,密钥层管的是长期用量
- 分接口设定额度。列表类接口最贵(一次能拿走一批),详情类可以宽松些
- 超限时返回明确的状态码和重试时间。含糊地返回 403 或者干脆断开,只会让对方换策略
- 给守规矩的爬虫留门。按 UA 判断不可靠,要验证就做反向加正向的域名解析验证,别一刀切
还有一条经验:限流的阈值要留够余量给正常用户。宁可松一点也别把真实访客挡在外面,误伤的代价通常比被抓走的代价高。
robots.txt 该怎么写
robots.txt 是声明,不是锁。它挡不住执意要抓的人,但它有两个不可替代的作用:一是告诉守规矩的抓取方你的意图,二是对方执意违反时,你有了一份"已经明确告知过"的证据。
目录站上通常要写进去的:接口路径、搜索结果页、排序筛选组合、中转跳转路径。这些页面被抓既浪费预算又没价值。
页面上放什么,决定了被抄时你能拿回什么
技术防线会被绕过,所以要把来源信息织进数据里:
- 条目页上显著位置标注本站名称和条目地址
- 自己写的描述文字里,自然地包含站点信息——抄走描述的人往往连这段一起抄
- 截图和缩略图上加可见的来源标识,图片比文字更难被自动去掉
- 每条数据的发布时间、更新时间真实可查,这是证明"我先有"的关键
维权的难点从来不是证明对方抄了你,是证明这份内容你比他早就有。所以时间戳和发布记录要提前留好,别等出事再去补。
什么时候该走授权而不是硬拦
如果对方是有稳定用户量的产品、且愿意标注来源,谈授权通常比打官司划算——可以约定来源展示方式、数据更新频率、使用范围。反过来,如果对方是纯采集站、内容全是搬运、连联系方式都没有,那就不用谈,直接走投诉通道。
判断标准很简单:对方的用户能不能顺着来源找到你。能,就是潜在的合作方;不能,就是在白嫖。
监控比防御更重要
完全防止被抓不现实,但及时发现能大幅降低损失。值得做的监控:接口调用量按来源的异常波动、整站数据被批量请求的模式(按分类顺序、短时间连续 ID)、站名在别处被提及的新增情况。这三项加起来成本不高,但能让你在被搬空之前知道。
数据开放不是非黑即白。把"随便谁都能拿"和"谁都拿不到"之间划出几档,每档配对应的限制和回报,比单纯堵漏洞有效得多。