
JS 没跑起来的那几秒:目录站该留的那层不依赖脚本也能看的页面
 J
现代前端把越来越多的东西搬到客户端,目录站也跟着走:列表用接口拉、筛选在前端做、翻页不刷新。用户体验确实顺了,但风险也一起搬了过来——脚本没跑起来的时候,页面还剩什么?
图片来源:网络,版权归原作者所有,侵权请联系删除
渲染不是免费的,也不是每次都成功
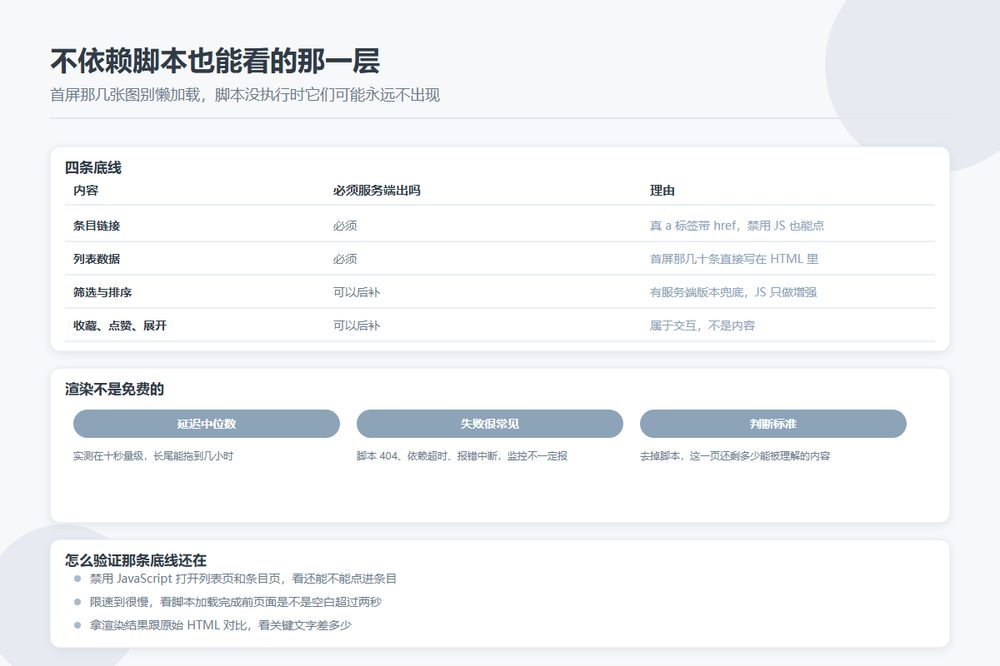
搜索引擎渲染页面用的是无头浏览器,要排队、要下载资源、要执行脚本。实测数据里,渲染延迟的中位数在十秒量级,长尾能拖到几小时。也就是说,你页面上靠 JS 才能出现的内容,有可能在抓取的那一刻还没出现。
更现实的是失败:某个 CDN 上的脚本 404 了、某个第三方依赖超时了、脚本报错中断了。这些情况你的监控不一定报,因为对真实用户来说也许只是慢一点,但对爬虫来说那一页就是空的。
四条底线
| 内容 | 必须服务端出吗 | 理由 |
|---|---|---|
| 条目链接 | 必须 | 真 a 标签带 href,禁用 JS 也能点 |
| 列表数据 | 必须 | 首屏那几十条直接写在 HTML 里 |
| 筛选与排序 | 可以后补 | 有服务端版本兜底,JS 只做增强 |
| 收藏、点赞、展开 | 可以后补 | 属于交互,不是内容 |
判断标准只有一句:去掉脚本,这一页还剩多少可被理解的内容。剩下的部分就是你的真实内容量。内容站按这个标准自查,常常会发现剩下的是一个空壳。
链接必须是真链接
这条最容易被破坏。为了点击统计,很多站把条目链接改成走一个中转函数,href 写成了 #,真正的跳转在 JS 里。统计是拿到了,链接没了。
正确做法是先有正常的 href,再在点击时追加统计。这样脚本挂了,用户照样能点开,爬虫照样能顺着爬。中转跳转页该保留就保留,但那是在 href 指向的地址上做文章,不是把 href 干掉。
折叠和懒加载要留后路
折叠内容本身没问题,HTML 里有就行。但如果折叠是「先占位、点击后再请求内容」,那就等于把内容交给了脚本。折中的做法是首屏内容直接输出,折叠的次要内容用 noscript 留一份,或者干脆默认展开、由脚本在加载后收起——顺序反一下,代价很小,风险降很多。
图片懒加载同理。首屏那几张别懒加载,写了 loading=lazy 的图在脚本没执行时可能永远不加载,而首屏截图恰恰是条目页最有用的信息。
别让一颗依赖拖垮整页
统计代码、客服组件、广告脚本,这些第三方依赖挂了不该影响内容呈现。做法是把它们放在页面末尾异步加载,并且加超时和失败兜底。目录站尤其要小心那些整站插入的组件——它们通常被塞进公共模板,一出事就是全站。
怎么验证你站上那条底线还在
- 浏览器禁用 JavaScript,打开列表页和条目页,看能不能正常浏览、能不能点进条目。
- 把网络限速到很慢,看脚本加载完成之前页面是不是空白,空白超过两秒就要调整。
- 用抓取工具的渲染结果跟原始 HTML 做一次对比,看两边的关键文字差多少。
这三条每月跑一次就够。它不解决排名问题,但它能保证你在别的环节做的努力不会因为一次脚本事故全部作废。