
限流把蜘蛛也限了:403、429 和 WAF 规则里该给爬虫留的那道门
 限
目录站是被采集的重灾区,条目数据、外链地址、分类结构,别人拿去就能搭一个一模一样的站。所以上 WAF、上频率限制是合理的。问题在于蜘蛛的请求特征和采集脚本确实有重叠:密集、无 Cookie、User-Agent 里带 bot 字样。一刀切下去,先死的是收录。
图片来源:网络,版权归原作者所有,侵权请联系删除
几个状态码在爬虫眼里是什么意思
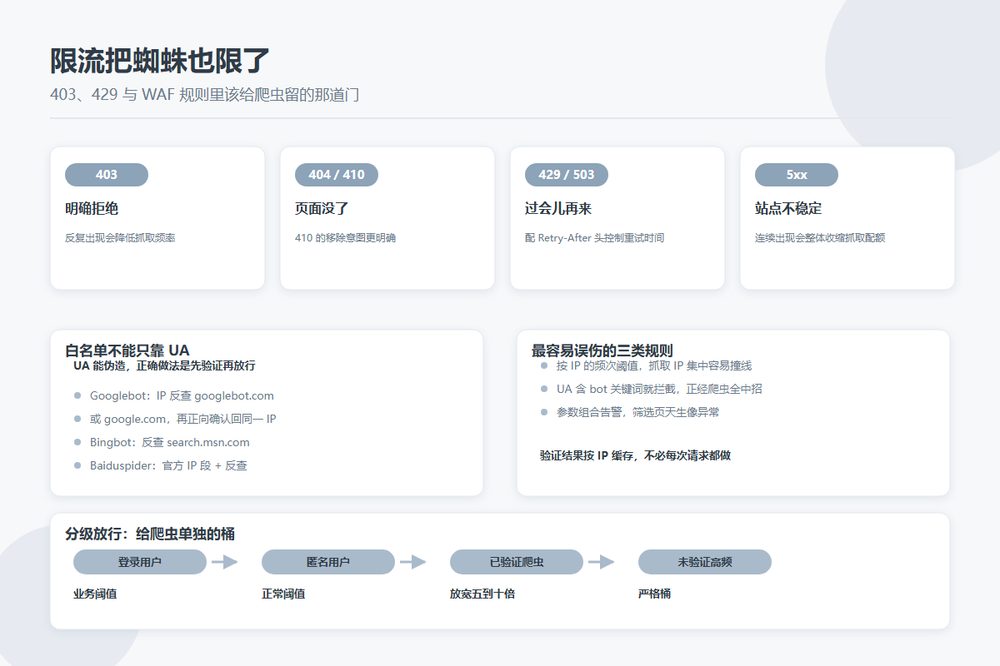
403 是明确的拒绝。页面反复返回 403,爬虫会认为这里无权访问,抓取频率会降下来,持续一段时间就可能从索引里掉出去。404 和 410 表示页面没了,410 的移除意图更明确。429 和 503 属于「过会儿再来」的信号,配 Retry-After 头可以让重试时间可控,偶尔出现影响不大,长期大量出现会让抓取速度被调慢。5xx 是另一回事,连续 5xx 会被当成站点不稳定,抓取配额整体收缩。
所以同样是「拒绝」,用错码的后果完全不同。想让爬虫等一会儿再来,返回 429 加 Retry-After;想让它别碰某个路径,用 robots.txt;不想让它索引,用 noindex 但保持 200。直接甩 403 是最粗暴的一种,通常也是误伤最重的。
目录站最容易误伤的三类规则
第一类是按 IP 的频次阈值。搜索引擎的抓取 IP 集中在少数网段,抓取高峰期很容易撞上「单 IP 每分钟 N 次」这条线。第二类是 UA 里含 bot、spider、crawler 关键词就拦截或限速,这条规则本意是防采集,但正经爬虫的 UA 里恰恰都带这些词。第三类是参数组合规则,目录站的筛选页和排序页本来就会生成大量带参数的 URL,蜘蛛顺着链接爬几层,就触发了「异常参数访问」告警。
白名单怎么写才不是后门
先看一个反例:if (UA contains "Googlebot") then allow。任何人都能把 UA 改成 Googlebot,这条规则等于给采集者开了绿灯。正确的做法是先验证再放行,验证方式是官方给的:
Googlebot 用 DNS 反查:对访问 IP 做反向 DNS 解析,得到的主机名应当以 googlebot.com 或 google.com 结尾;再做正向 DNS 确认,解析回同一个 IP。两边都对上才算通过。谷歌也提供了官方的 IP 段 JSON 文件,可以直接拿来比对。Bingbot 同理,官方公布的方式是反查到 search.msn.com。百度的 Baiduspider 也有官方的 IP 段和 UA,做法是对 IP 反查,确认属于 baidu.com 或 crawl.baidu.com 下的域名。
验证有成本,不用每次请求都做。通常是缓存验证结果,按 IP 缓存一段时间,过期再验一次。爬虫的 IP 段变动不频繁,这个开销可以接受。
分级放行:给爬虫单独的桶
把所有流量塞进一个限流桶是不合理的。比较清楚的分法是四个桶:登录用户、匿名用户、已验证爬虫、未验证的高频访问。前两个按正常的业务阈值走,已验证爬虫的阈值放宽但不是无限,比如放到匿名阈值的五到十倍,未验证的直接走严格桶。
这样配的好处是:采集脚本伪装成 Googlebot 也过不了验证,照样被限;真爬虫有足够配额把站爬完;正常用户完全不受影响。另外记得给规则加日志埋点,拦截时记下 UA、IP、路径、规则名,否则事后根本查不出是谁被拦了。
已经误伤了怎么确认和恢复
确认方法很直接:把服务器日志里 403 和 429 的记录筛出来,按 UA 和 IP 段做交叉统计,看里面有没有官方爬虫。同时看 Search Console 的抓取统计报表,抓取量和响应时间会一起变化。如果确认了,先把已验证爬虫放进独立桶,观察 48 小时,正常情况下抓取量会在一两天内回升。
有一点要提醒:别指望 429 能同时解决采集和收录。429 是在告诉对方「慢一点」,对讲规矩的爬虫管用,对铁了心要抓你的人没有任何约束力。采集这件事得靠 robots、频率限制、验证码和法务手段分开处理,别指望一个状态码全包了。