
结构化数据报错怎么排:三个验证工具各查什么,目录站的排错顺序
 结
目录站标结构化数据,最常见的三种下场:标完没报错也没效果;工具里全绿,线上就是不出富媒体;昨天还好好的,改了个模板之后整站报错。这三种情况各有各的原因,但排查的入口其实是同一套工具。
图片来源:网络,版权归原作者所有,侵权请联系删除
三个工具,三种口径
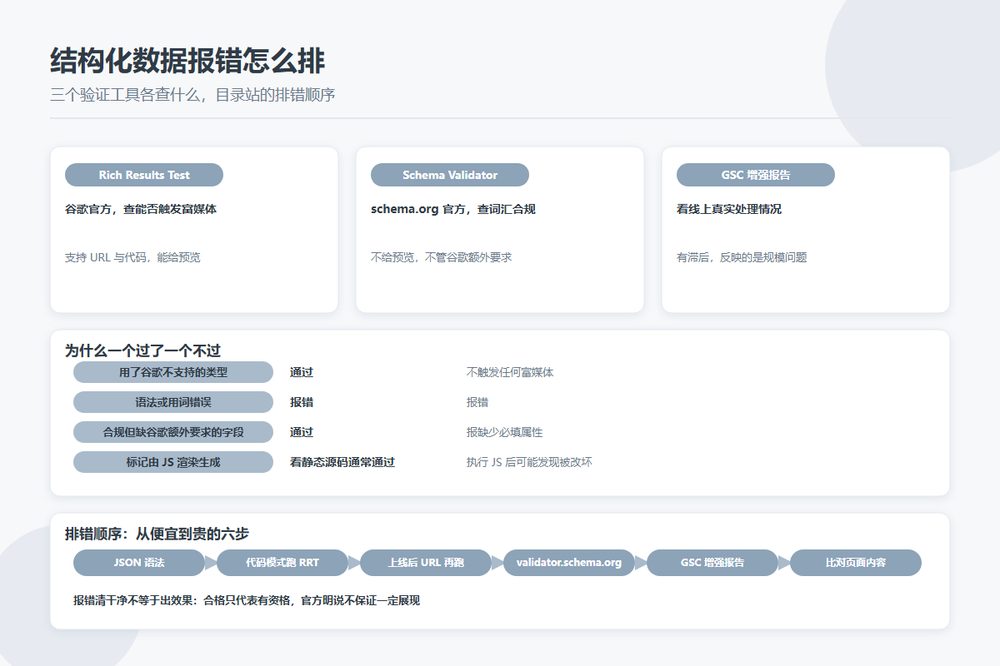
Rich Results Test(search.google.com/test/rich-results)是谷歌自己的工具,回答的问题是「这段标记能不能触发谷歌支持的某种富媒体结果」。它支持贴 URL 也支持直接贴代码,能给出预览,会区分错误(error)和警告(warning)。警告通常是不影响生效的缺失项,错误才是阻断项。
Schema Markup Validator(validator.schema.org)是 schema.org 官方的,回答的是「这段标记在 schema.org 词汇体系里合不合规」。它检查语法、类型、属性名是否真实存在,支持 JSON-LD、Microdata、RDFa 三种写法,但不给任何富媒体预览,也不管谷歌那套额外要求。
Search Console 的增强报告是第三类,看的是已经上线、已经被抓取处理过的页面实际报了什么。它有滞后,通常要等谷歌重新抓取一遍才会更新,但它是唯一能反映线上真实情况的。
为什么一个过了一个不过
| 情况 | Schema Markup Validator | Rich Results Test |
|---|---|---|
| 用了谷歌不支持的类型 | 通过 | 不触发任何富媒体 |
| 语法或用词错误 | 报错 | 报错 |
| 语法合规但缺谷歌额外要求的字段 | 通过 | 报缺少必填属性 |
| 标记内容是 JS 渲染后才生成的 | 看静态源码,通常通过 | 执行 JS,可能发现被改坏 |
两边结论不一致不代表哪个错了,它们本来就是两把不同的尺子。前者是通用词汇,后者是谷歌的商业规则,谷歌只支持 schema.org 全量词汇里的一部分用于富媒体展现,还在上面加了自己的要求。官方文档也说得很明白:结构化数据让某种展现成为可能,但不保证一定展现。
目录站的排错顺序
我一般是这么走的,六步,从便宜到贵:
1. 先过一遍 JSON 语法。逗号、引号、括号,这类错误会让工具直接从出错那行往后全读不出来,报出一堆看起来毫不相关的错。用任意一个 JSON 校验器过一遍,十秒钟的事。
2. 用 Rich Results Test 的代码模式贴进去跑。这一步不用上线,改起来最快,适合边写边调。
3. 上线之后,用同一个工具的 URL 模式再跑一次。这一步不能省,因为你的模板可能在服务端拼字符串时把内容拼坏了,或者 JS 在客户端又改了一遍 DOM。静态代码全绿、线上全红,八成是这一步的问题。
4. 拿 validator.schema.org 过一遍词汇。尤其是用了谷歌不支持的类型时,只有它能告诉你标记本身是不是干净的。
5. 等谷歌抓过之后看 GSC 增强报告,看的是规模问题:是不是某一类模板整批报错,而不是个别页面写错了。
6. 最后人工比对一遍:标记里的名称、URL、日期,和页面上肉眼可见的内容是不是一致。标记写的内容和页面实际内容对不上,是比语法错误更麻烦的问题。
目录站最常见的四种错
类型名拼错是最常见的,schema.org 里是 Organization,不是 Organisation;属性名区分大小写,写错一个字母就是另一个不存在的属性。第二是 URL 缺协议,写 www.example.com 而不是 https://www.example.com/。第三是日期格式,要用 ISO 8601,写成「2026年10月」这种是过不去的。第四类更隐蔽:ItemList 里每个条目的 url 指向了一个被 robots 拦掉或者已经 404 的地址,工具未必报错,但这段标记实际没什么用。BreadcrumbList 少给最后一项的 item 也是同类问题。
报错清干净之后别急着庆祝,去 GSC 的增强报告里看一眼这个类型的展现数据有没有变化。没有变化是正常的,前面说过,合格只代表有资格,不代表一定给。把「标了就该出效果」这个期待先放下,能省掉很多无意义的返工。