
运营要看的那张报表把主库拖慢了:目录站的报表查询该怎么隔离
 运
目录站平时的查询都很轻——按分类取二十条、按 ID 取详情。真正的麻烦来自另一类请求:运营要看的统计、月度盘点、导出全量数据。这些查询扫描的行数是正常请求的上千倍,而它们往往是在业务高峰期跑的。
防线要从最便宜的一道开始加。
图片来源:网络,版权归原作者所有,侵权请联系删除
第一道:给语句设一条死线
两个引擎都有服务端语句超时,但覆盖范围差得很远,用错了等于没设。
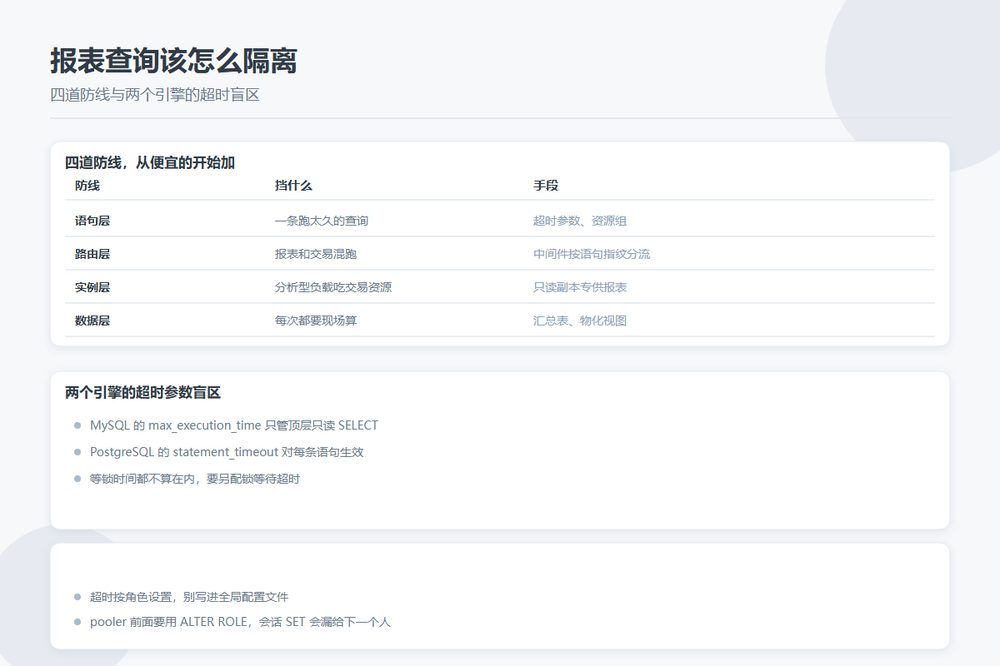
MySQL 的 max_execution_time 从 5.7.8 起提供,单位是毫秒,默认 0 表示不限制。它只作用于顶层只读 SELECT:写语句不管、子查询和派生表不管、存储程序里的语句也不管。也就是说,一条跑飞的 UPDATE 在 MySQL 上没有任何服务端时间上限,只能靠人工 KILL 或者外部看门狗。
PostgreSQL 的 statement_timeout 默认同样是 0(关闭),但一旦设置,它对该会话的每一条语句都生效,包括 VACUUM 这类维护命令。设在全局配置文件里,周末的维护脚本会跟着一起超时报错。正确的位置是按角色设置:
ALTER ROLE app_rw SET statement_timeout = '5s';
ALTER ROLE report SET statement_timeout = '60s';
ALTER ROLE maintenance SET statement_timeout = '2h';
这样应用连接卡得住,报表角色有足够时间跑完,维护任务不受影响。用连接池的话尤其要走 ALTER ROLE,因为事务级池化下,会话里的一次 SET 会漏给下一个借用到这条连接的人。
还有一点:语句超时管的是执行时间,等锁的时间不算在内。PostgreSQL 要另外配 lock_timeout,MySQL 对应的则是 innodb_lock_wait_timeout。
第二道:把报表流量导到别处
超时只能止损,不能隔离。真正的隔离是把两类负载分开跑。
| 防线 | 挡什么 | 手段 |
|---|---|---|
| 语句层 | 一条跑太久的查询 | 超时参数、资源组 |
| 路由层 | 报表和交易混跑 | 中间件按语句指纹分流 |
| 实例层 | 分析型负载吃交易资源 | 只读副本专供报表 |
| 数据层 | 每次都要现场算 | 汇总表、物化视图 |
第三道就是给报表单独挂一个只读副本。目录站的数据量通常撑不起一整套数仓,一个副本够用了。要注意两点:副本有延迟,报表数据比主库晚几秒到几十秒是常态,界面上要写明数据截止时间;副本挂了要有降级,报表失败不能拖累主流程。
第四道:能预计算的别现场算
大部分运营报表不需要实时。按天或按小时跑一次汇总,结果写进一张小表,前端直接读这张表,查询时间从四十秒降到几毫秒。目录站常见的几个统计——各分类条目数、本周新增、失效条目数——全部适合这么做。
汇总任务本身也该设超时和告警。跑失败了要有人知道,否则运营看到的是一份三天前的数,还以为是真实情况。
这四道不用一次全上。小站先把语句超时配上,就能挡掉八成的突发状况;等报表真的开始影响前台了,再往副本和汇总表上投入。