
搜索页的缓存该不该开:目录站搜索结果缓存的四个判断点
 搜
分类页可以整页静态化,条目页可以按 ID 缓存,唯独搜索页麻烦:查询词是自由输入的,理论上有无限种组合。于是很多团队的选择是不缓存,然后数据库在高峰期被搜索拖垮。
其实搜索结果页的缓存是可以做的,只是规则得比别的页面细。
图片来源:网络,版权归原作者所有,侵权请联系删除
第一点:只缓存高频且无个性的那部分
先把请求分两类。一类是匿名的、查询词集中在头部的一批(行业里常见的数据是前几百个词占了大部分搜索量),结果对所有人都一样。另一类是登录用户的搜索、带个性化排序的、或者查询词极长尾的。
只有前一类值得进缓存。判断标准就一句话:同样的输入,两个不同的人得到的结果必须完全一致。只要结果里掺了用户画像、浏览历史、地域推荐,这块就不能进公共缓存,否则用户 A 会看到用户 B 的结果——这种串味比慢一点严重得多。
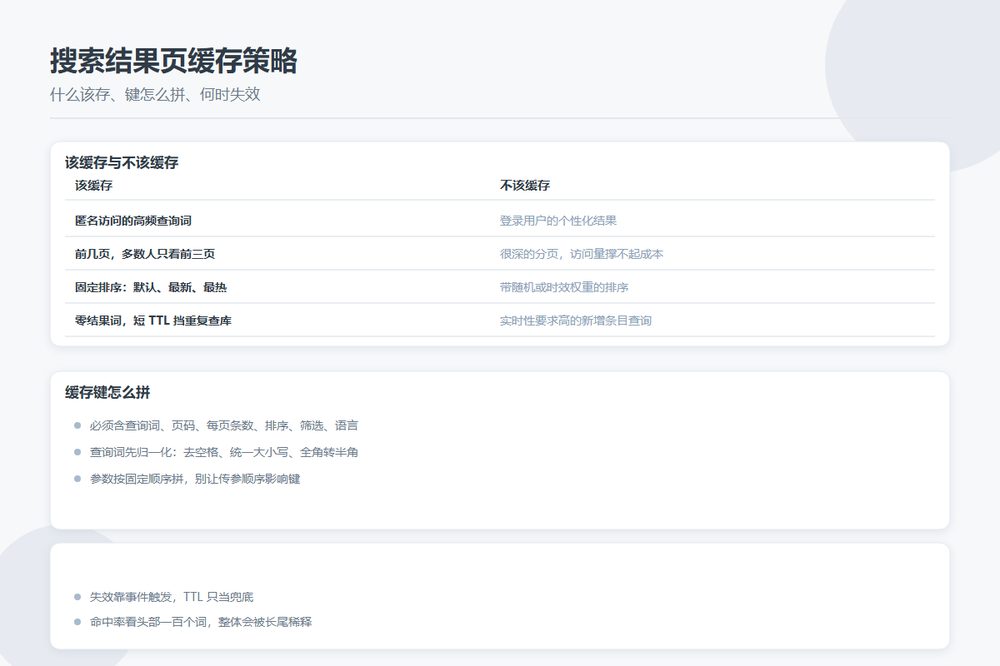
| 该缓存 | 不该缓存 |
|---|---|
| 匿名访问的高频查询词 | 登录用户的个性化结果 |
| 前几页(多数人只看前三页) | 很深的分页(访问量撑不起缓存成本) |
| 固定排序(默认、最新、最热) | 带随机或时效权重的排序 |
| 零结果词(短 TTL 挡住重复查库) | 实时性要求高的新增条目查询 |
第二点:缓存键要拼全,也要归一
缓存键里必须包含:归一化后的查询词、页码、每页条数、排序方式、筛选条件、语言版本。少一个就会串。
归一化指的是把用户输入先洗干净再拼键——去首尾空格、统一大小写、全角转半角、繁简可以不做但同义词映射要做(如果站内有同义词表,映射后的规范词才是键的一部分)。不归一化的结果是「建站」和「建站 」被当成两个键,命中率直接腰斩。
顺带一提,排序参数要按固定顺序拼,别让用户传参的顺序影响键,否则同一个查询能生成好几个等价的键。
第三点:失效要主动,别只靠过期时间
纯靠 TTL 的问题是:新条目上线后,搜它的人半小时都搜不到;条目下架后,结果页里还挂着一条点进去 404 的链接。
做法是 TTL 只当兜底,主力靠事件触发:条目增删改时,按受影响的查询词删掉对应键。词和条目的对应关系可以从条目的分类、标签、分词结果倒推,粗一点没关系——多删几个键只损失一点命中率,漏删才是问题。
零结果也要短暂缓存,比如 30 秒到 2 分钟。不然一个不存在的词被连续查几百次,每次都去扫一遍索引,这就是典型的缓存穿透。
第四点:命中率要看对口径
第一版上线的命中率通常只有两三成,这是正常的,别急着判死刑。要看三个数:整体命中率、头部一百个词的命中率、以及缓存占用的内存量。真正有意义的是第二个——头部词的命中率上到七成以上,数据库的压力就下来了,整体命中率被长尾词稀释是必然的。
内存要设上限并配 LRU 淘汰,否则缓存会无限膨胀。按经验给搜索缓存单独划一块,别和条目缓存、会话缓存混在一个实例里,一个慢查询打满内存,全站跟着抖。
缓存解决的是重复劳动,解决不了慢查询本身。如果某个词的查询从未命中过缓存、每次都要跑三秒,那是索引和 SQL 的问题,加缓存只是把疼痛延迟了。