
统计后台的数字别全信:目录站该不该自建访问统计,两边的数怎么对
 统
月初对数据时发现两个数字对不上:统计后台 4200 次访问,日志里过滤掉爬虫后是 6800 次。差了六成。这类差异不是谁坏了,是两套工具记的根本不是同一件事。
图片来源:网络,版权归原作者所有,侵权请联系删除
第三方脚本会少记什么
统计脚本本质是一段 JS,要执行了才记数。中间任何一个环节断了,这次访问就不存在。
- 广告拦截插件和隐私类扩展会拦截常见统计脚本的域名,站长类、技术类受众里这个比例不低。
- 无 JS 环境、脚本加载失败、被 CSP 挡住,都不会记。
- 隐私模式下部分存储被清,跨页的会话可能被拆成多次。
- 部分产品在数据量小时会做阈值处理,长尾维度(比如具体来源、设备型号)会被合并或隐藏。
- 采样。报表维度越细越容易触发,看趋势可以,算绝对值会偏。
反过来说,它几乎不会多记。执行了脚本的,基本都是真实浏览器。
日志会少记什么,多记什么
日志记的是请求,只要请求到了服务器就有记录。但两头的误差方向完全不同。
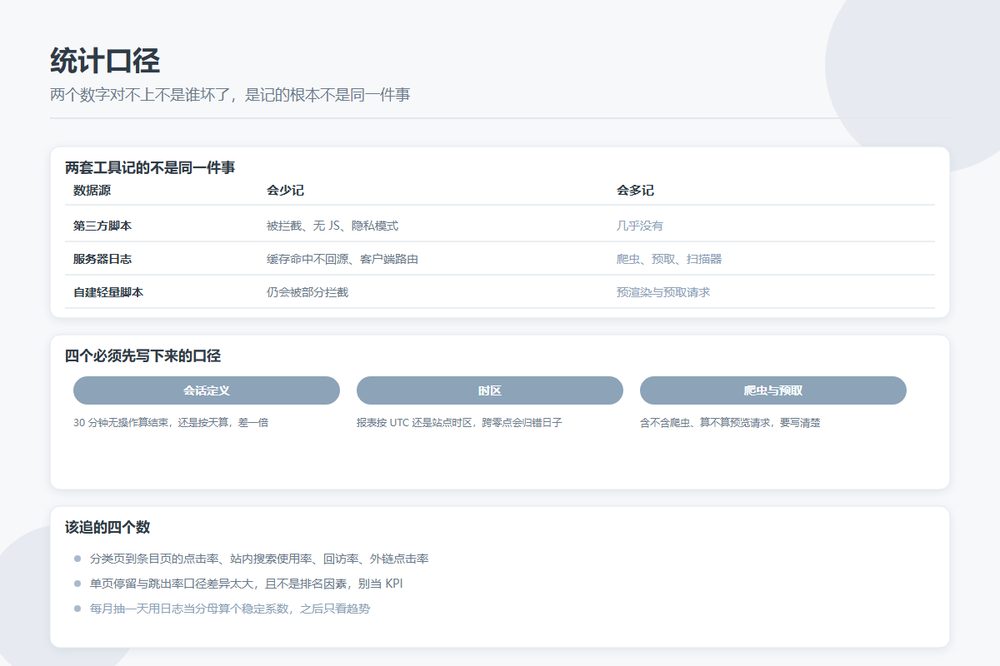
| 数据源 | 会少记 | 会多记 |
|---|---|---|
| 第三方脚本 | 被拦截、无 JS、隐私模式 | 几乎没有 |
| 服务器日志 | 缓存命中不回源、客户端路由跳转 | 爬虫、预取、扫描器 |
| 自建轻量脚本 | 仍会被部分拦截 | 预渲染与预取请求 |
「缓存命中不回源」这一条经常被忽略。如果你的页面走了 CDN,一次访问可能压根没到你服务器,日志里自然没有。所以用日志当基准之前,先确认 CDN 日志也能拿到。
自建统计的三条路
一是日志解析,goaccess 这类工具能直接出报表,全量、不漏,但要处理日志轮转、增量解析、爬虫识别,运维成本不低。
二是自建轻量脚本,一两 KB,跑在自己域名下,被拦截的概率比第三方低很多,因为拦截列表主要针对知名统计域名。代价是仍会丢一部分,且要自己写存储和报表。
三是两者结合。日志算总量,脚本算行为(页面停留、点击位置这些日志拿不到)。我倾向这条,因为两者的短板互补。
四个必须先写下来的口径
不把口径定清楚,换工具那天所有历史数据都作废。
- 会话怎么定义。30 分钟无操作算结束,还是按天算?两种算法的会话数可能差一倍。
- 时区。报表按 UTC 还是站点时区?跨零点的那批访问会归到不同日子。
- 是否含爬虫。包含的话数字好看但没意义,排除的话要写清楚排除规则。
- 是否含预渲染与预取。浏览器预取、社交平台的链接预览都会产生请求,算不算访问?
把这四条写进一份内部文档,贴在数据看板旁边。新同事接手时能省掉很多争论。
用日志当基准的具体做法
每月挑一天,把日志按 UA 和 IP 过滤出真人请求(排除已知爬虫 UA、排除单 IP 高频、排除静态资源),得到一个当天真实访问量。再和统计后台同一天的数字比,算出一个系数。
比如连续三个月都是后台数字乘 1.6 接近日志,那这个 1.6 就可以当成稳定的修正系数。之后日常只看后台的趋势和比值,需要绝对量时再乘回去。
这个办法不精确,但比「两个数字对不上就换工具」有用得多。换工具之后还是会有一批人丢,只是丢的比例变了。
匿名化与告知
统计用途也要合规。IP 不落盘或截断最后一段、Cookie 只在必要范围使用、隐私政策里写清收集什么用来做什么。国内《个人信息保护法》讲的是最小必要,纯统计用途不难满足,难的是你真的去写了那句说明。
自建的好处在这里体现:数据不出自己的服务器,不涉及第三方跨境传输,解释起来简单。
哪些数字根本不用追
单页停留时长、跳出率。这两个指标的口径差异极大,不同工具算出来能差一倍,而且早已不是排名因素。盯着它们优化,容易做出「把页面拆成两页降低跳出率」这种自欺欺人的动作。
目录站该追的是这几个:分类页到条目页的点击率(反映列表质量)、站内搜索使用率(反映类目划分是否合理)、回访率(反映有没有留存价值)、外链点击率(反映条目信息是否足以让人下决定)。这四个数都由你自己的行为数据决定,不受工具口径影响。