
分类树别只存个 parent_id:邻接表、路径枚举和闭包表的选择题
 分
目录站的分类几乎都会长成树:大类套小类,小类再套子类。建表时人人都会写一个 parent_id 字段,然后问题就来了——面包屑要一层层往上查,某大类下到底有多少条目要一层层往下算。分类到三四层、总量上千之后,这些查询会越来越难受。
图片来源:网络,版权归原作者所有,侵权请联系删除
先看三种模型各长什么样
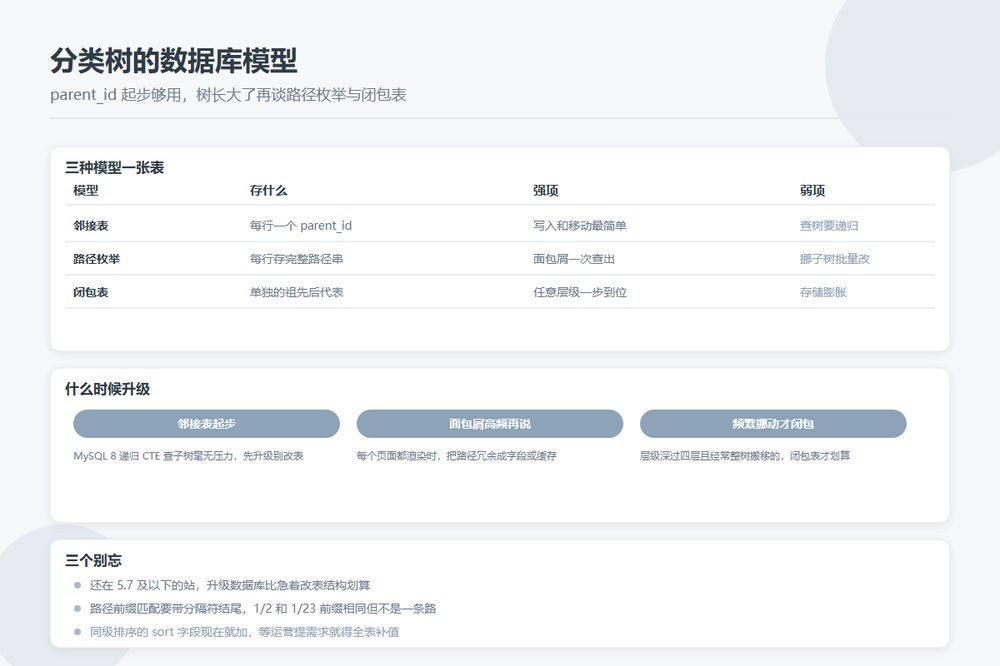
| 模型 | 存什么 | 强项 | 弱项 |
|---|---|---|---|
| 邻接表 | 每行一个 parent_id | 写入和移动最简单 | 查祖先/后代要递归 |
| 路径枚举 | 每行存完整路径串 | 面包屑一次查出 | 移动子树要批量改路径 |
| 闭包表 | 单独一张祖先-后代表 | 任意层级查询一步到位 | 存储膨胀,维护成本高 |
邻接表没有那么不堪
很多人以为邻接表查不了树,其实是老数据库不支持递归查询留下的旧印象。MySQL 8.0 起有了递归 CTE,用一条 WITH RECURSIVE 就能把整棵子树或祖先链查出来,外加索引配合,几千个分类的规模毫无压力。
所以结论的前半句是:还在用 5.7 及以下的站,先升级数据库,比急着改表结构划算。
什么时候值得上路径枚举或闭包表
两个信号。一是面包屑和子树统计成了高频查询——每个页面都渲染面包屑、首页要展示每个大类下的条目总数,这类「读多写少」的场景,路径枚举一行数据就能出结果,不用递归。二是分类树经常整体挪动——运营调整时把一整个子类连同孙类挂到别的大类下,闭包表虽然写入时要多维护一张表,但挪动逻辑写对之后,查询侧永远是一步到位。
路径枚举有个经典陷阱要说清:路径串是靠分隔符拼的,查询时用「前缀匹配 + 分隔符结尾」的条件,别直接 LIKE 前缀。'1/2' 和 '1/23' 前缀相同但完全是两条路,这种错在数据量上来后才暴露。
给目录站的落地建议
三步走:起步用邻接表加递归 CTE,把「分类路径」做成一个查询函数;面包屑出现在所有页面的,把路径冗余成字段或缓存;分类树有频繁搬动需求、且层级深过四层的,再考虑闭包表。
模型的升级成本远低于数据错误的修复成本。换模型前先写好迁移脚本的双向校验:新旧模型各自查一遍所有分类的祖先链,结果不一致的行一条都不能放过。
最后一个字段别忘:sort。同级的展示顺序总要有个依据,等运营提需求的时候再加,就得给全表补值了。