
站内搜索还在 LIKE '%关键词%':什么时候该换全文索引,什么时候不用
 站
目录站的搜索框是个不起眼的性能炸弹。早期用 LIKE '%关键词%' 糊一个,几千条数据完全够用;等条目上到几万条,每次搜索都是全表扫描,数据库一卡整站跟着慢。更麻烦的是中文:按词匹配的前置通配符写法,传统索引帮不上忙。
图片来源:网络,版权归原作者所有,侵权请联系删除
先承认 LIKE 的问题不止慢
它还没有相关度。命中十条结果,哪条排前面?按主键倒序排,用户要找的最相关那条可能压在最后。搜索体验差,用户下次就直接回搜索引擎了,搜索框白放。
MySQL 全文索引的中文方案
InnoDB 的 FULLTEXT 索引支持 ngram 分词器,正是为中日韩这类无空格语言准备的,MySQL 5.7.6 起内置。中文按二元切分(默认 token 是两个字符,可调),「网站收录」会被切成「网站」「站收」「收录」这样的片段参与匹配。
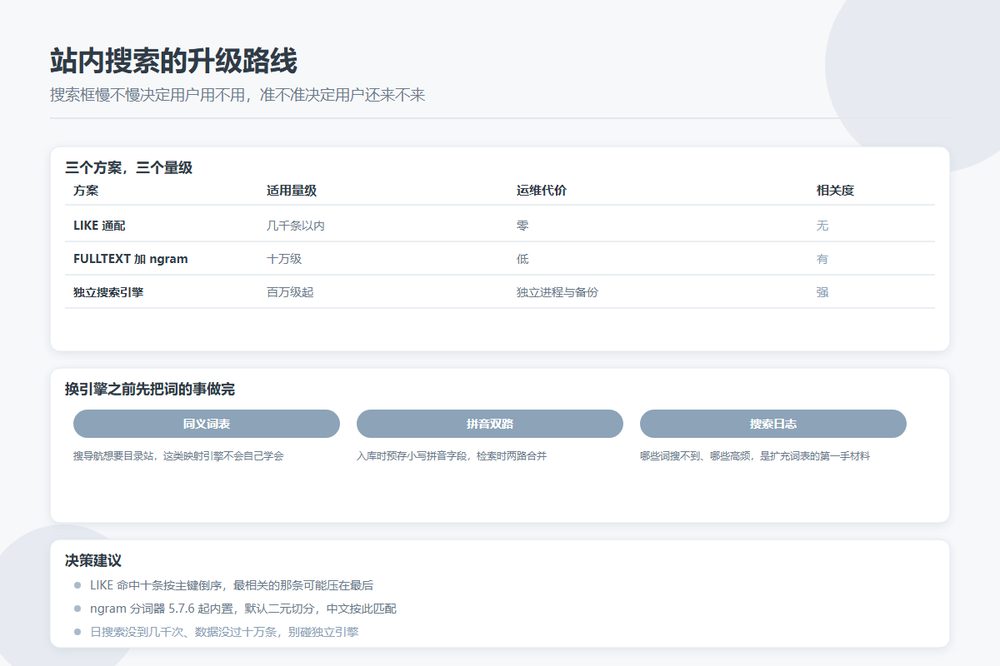
它的能力边界要心里有数:十万级条目、检索字段就标题加简介,FULLTEXT 完全胜任,查询毫秒级;到百万级、或者要做同义词扩展、拼音匹配、复杂排序加权,它就开始吃力。
| 方案 | 适用量级 | 运维代价 | 额外能力 |
|---|---|---|---|
| LIKE 通配 | 几千条以内 | 零 | 无相关度 |
| MySQL FULLTEXT + ngram | 十万级 | 低,注意索引维护 | 相关度排序 |
| 独立搜索引擎 | 百万级起 | 独立进程、内存、备份 | 同义词/拼音/复杂加权 |
换引擎之前,先把「词」的事做完
上独立搜索引擎救不了分词没做好的站。用户搜「导航」想要的是「目录站」,搜拼音想搜中文,这类映射是业务知识,任何引擎都要你喂数据:维护一张同义词表,查询时先扩展再检索;拼音在入库时预存一份小写字段,检索时双路合并。
搜索质量的另一头是结果太少怎么办、太多怎么截。零结果的兜底逻辑之前专门写过,这里只强调一点:搜索日志留下来。哪些词搜不到、哪些词高频出现,是你扩充同义词表和补充分类的第一手材料,比任何工具的建议都准。
搜索框是用户意图最直白的入口。它慢不慢决定用户用不用,准不准决定用户还来不来。
给个直接的决策建议:日搜索量没到几千次、数据没过十万条的站,别碰独立搜索引擎,MySQL 的 FULLTEXT 加一张同义词表,够你安稳用很久。运维复杂度也是成本,省下来的时间拿去做内容。