
从日志还原蜘蛛走过的路线:目录站抓取路径分析的四个视角
 从
Search Console 的抓取统计给出的是汇总数字:多少页、什么状态码、耗时多少。它不告诉你顺序。而顺序恰恰是最有信息的部分——蜘蛛是从哪进来的、往下走了几层、在哪一层停住不走了。
这些信息只有服务器日志里有。
图片来源:网络,版权归原作者所有,侵权请联系删除
先把日志变成会话
原始日志是一行行请求。要做路径分析,得先切分成会话:把同一来源(真实爬虫 IP 加 User-Agent)的请求按时间排序,相邻两次请求间隔超过某个阈值(常用 30 分钟)就切一个新会话。切完之后,每个会话就是一条路径。
切分前必须做一件事:验证这些请求真的来自搜索引擎爬虫。做法是对 IP 做反向 DNS 解析得到域名,再对该域名做正向解析,确认解析回同一个 IP,并且域名后缀属于官方声明的范围。User-Agent 是可以伪造的,这一步跳不过。各大搜索引擎都提供公开的 IP 段数据用于核对。
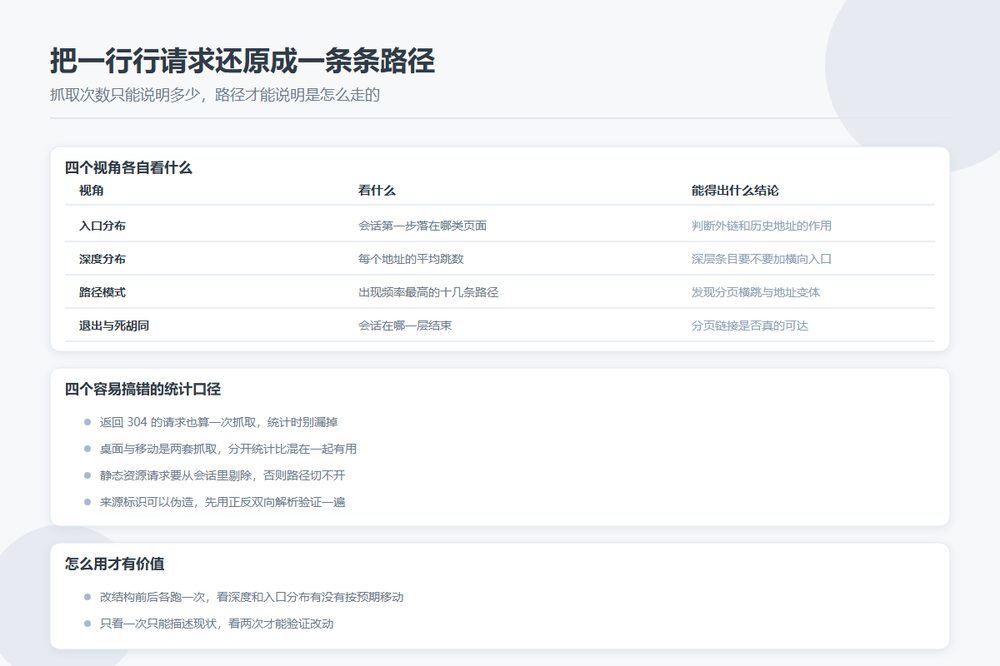
视角一:入口分布
看会话的第一步落在哪一类页面上。健康的目录站,入口应该集中在首页、sitemap、以及少量高权重分类页。
如果大量会话的第一步是某个深层条目页,通常说明外链结构或者历史遗留的地址在起作用;如果第一步大量落在带参数的搜索结果页,说明有外部链接指向了不该被收录的地址。
这个视角的结论很直接:入口集中的那几类页面,要保证它们的可达性和更新频率;入口意外出现的那些地址,要去查是谁在链。
视角二:深度分布
统计每个被抓 URL 在会话中的平均跳数。如果一个条目页平均要五跳才被抓到,它的重要性在结构上就被低估了。
目录站常见的形态是:首页 → 分类页 → 子分类 → 条目页,四层。条目量大的时候,深层的条目页抓取频率会明显低于浅层。解决办法不是改抓取频率设置,而是加横向入口——把新条目和热门条目直接挂到首页、分类页和「本周新增」这类聚合页上。
视角三:路径模式
把出现频率最高的十几条路径列出来。你会看到的典型模式有:首页直通条目(来自 sitemap 或推送)、分类内的横向跳转、以及分页链路。
值得警惕的是两种畸形模式:一是在分页里反复横跳,说明分页结构没给爬虫清晰的增量信号;二是同一会话内反复抓同一批 URL,通常是 URL 变体太多(参数顺序、大小写、末尾斜杠)导致同一个页面有多个可达地址。
视角四:退出与死胡同
看会话在哪一层结束。如果大量会话止步于分类页第一页,从不往下走,那问题多半出在分页链接的可达性上——比如分页是 JS 点击加载的,服务端输出里没有真实的 a 标签。
另一类是「死胡同页面」:有入口链接,但页面上没有任何指向站内的有效出链。典型例子是过期条目的详情页、以及只有一条内容的标签页。这类页面抓到就结束了,信号传不出去。
三个能直接落地的结论
| 观察到 | 说明什么 | 该动什么 |
|---|---|---|
| 深层条目抓取间隔很长 | 结构深度不够友好 | 加横向入口,缩短路径 |
| 大量请求落在带参数地址 | 存在 URL 变体 | 规范化 + 自引用 canonical |
| 会话止步于分类第一页 | 分页链接不可达 | 服务端输出真实分页链接 |
| 某批 URL 重复抓取 | 变体或重定向链 | 收敛到唯一规范地址 |
几个容易搞错的统计口径
带 If-Modified-Since 或 If-None-Match 的请求返回 304,也算一次抓取,只是没有传输正文。统计抓取量时要把 304 算进去,否则会低估爬虫的工作量。
Googlebot 有桌面和移动两套抓取,User-Agent 不同,路径偏好也可能不同。分开统计比混在一起有用。
静态资源请求(CSS、JS、图片)要从会话里剔除,否则会把一条路径切得七零八落——一个页面十几个资源请求,全算进去会话就永远断不开。
最后,日志分析的价值在于对比:改结构之前跑一次,改完一个月再跑一次,看深度分布和入口分布有没有按预期移动。只看一次只能描述现状,看两次才能验证改动。