
边缘函数该干的四件事和不该干的三件:目录站的取舍清单
 边
边缘函数跑在 CDN 节点上,用 V8 隔离环境而不是完整 Node,冷启动在毫秒量级。代价是运行时被削掉了一大块:没有 fs、child_process、net 这些直接访问操作系统的模块,能用的是 fetch、Request、Response、Headers、crypto 这类 Web 标准 API。
它对目录站的价值不在于「算得更快」,而在于有些判断可以在请求碰到源站之前就做完。
图片来源:网络,版权归原作者所有,侵权请联系删除
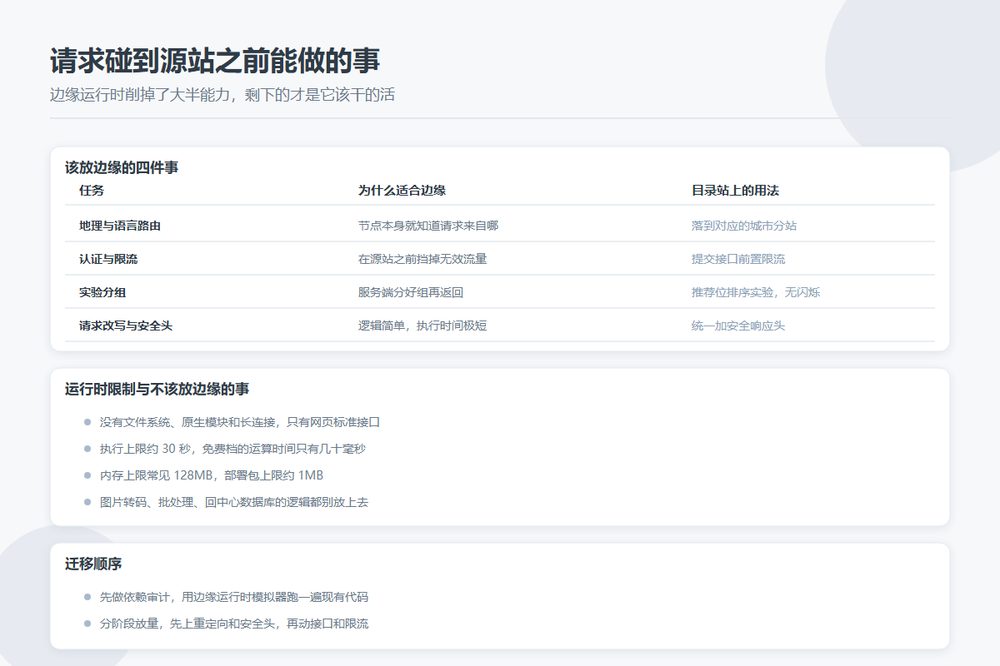
该放边缘的四件事
| 任务 | 为什么适合边缘 | 目录站上的具体用法 |
|---|---|---|
| 地理与语言路由 | 节点本身就知道请求来自哪 | 按地区落到对应城市分站,比在源站查库快 |
| 认证与限流 | 在源站之前挡掉无效流量 | 提交接口前置限流,异常 UA 直接拒 |
| A/B 分组 | 服务端分好组再返回,无客户端闪烁 | 推荐位排序实验,不影响爬虫看到的主体内容 |
| 请求改写与安全头 | 逻辑简单,执行时间极短 | 统一加安全响应头、规范化参数顺序 |
第四类看起来最不起眼,其实是最稳的起点。重定向规则、安全头、机器人识别这几项几乎不消耗 CPU,出错也容易回滚,适合拿来验证整条链路。
不该放边缘的三件
重计算。图片转码、视频处理、大 JSON 解析、机器学习推理,都会撞上 CPU 时间和内存上限。主流平台的执行上限在 30 秒量级,免费档的 CPU 时间甚至只有几十毫秒;内存常见上限是 128MB,包大小上限约 1MB。超了就是 503。
后台任务与长连接。批量导入、邮件队列、报表生成属于这一类;WebSocket 和数据库连接池也不合适,边缘环境没有常驻进程维持连接。
所有依赖中心数据库的逻辑。这是最容易被忽略的一条:边缘函数不能直接建 TCP 连接,传统 Postgres、MySQL 驱动用不了,得换成 HTTP 驱动或边缘原生存储。而如果你的数据都在单一区域的数据库里,每一次边缘请求都要跨区域往返一次,边缘带来的延迟优势会被这一次往返抵消掉。
还有个一致性问题要注意:边缘的键值存储通常是最终一致,传播延迟可能到 60 秒。库存、会话状态、需要强一致读写的内容都不该放上去。
目录站的一条现实路径
比较稳妥的架构是分三层:边缘节点处理请求路径上的轻量判断,容器或虚拟主机承载应用逻辑与数据库读写,后台任务交给队列与定时任务。
目录站里真正值得先搬的是这两块:一是出站跳转与旧地址重定向,二是提交接口的限流与预检。这两块逻辑短、无状态、出错可回滚,还能立刻减轻源站压力。
反过来,条目相似度计算、批量导入清洗、缩略图生成这三样别动,它们要么吃 CPU,要么吃内存,要么两者都吃。
迁移顺序
先做依赖审计。用 Miniflare 或各家提供的边缘运行时模拟器跑一遍现有代码,不被支持的 Node API 会直接报错。发现问题后换成 Web 标准写法,不要指望兼容层。
再分阶段放量。先上一个内部接口或 Webhook 接收器试水,确认部署、日志、回滚三条链路都通了,再逐步把重定向和限流搬过去。
最后一件事比较重要:边缘逻辑改的是响应,改的不是内容。如果同一 URL 对爬虫和用户返回了实质性不同的内容,那就踩到伪装的红线了。按地区换语言、按设备换布局这类调整是常规做法,但主体内容必须一致。
监控别漏
边缘函数出问题的表现和源站不一样:它不会让整站挂掉,而是让一部分请求变慢或返回 503。所以要单独盯三个数——执行时长分布、错误率、以及回源率的变化。回源率突然升高,往往说明缓存键变了或者边缘逻辑分支写错了。