
表越来越大但不是每条都常用:目录站条目数据的冷热分层该怎么分
 表
目录站的数据有个很明显的特征:访问分布极度不均。头部几百个热门条目扛掉了大部分流量,剩下大量条目几个月才被看一次,还有一批已经失效但基于留档需求不能删。
图片来源:网络,版权归原作者所有,侵权请联系删除
先别急着归档,先看看冷数据占了多少
判断方法:统计最近 90 天有访问记录的条目数量,跟总量对比。常见的比例是 10% 到 20% 承担了 95% 以上的访问。如果这个比例成立,冷热分层就值得做。
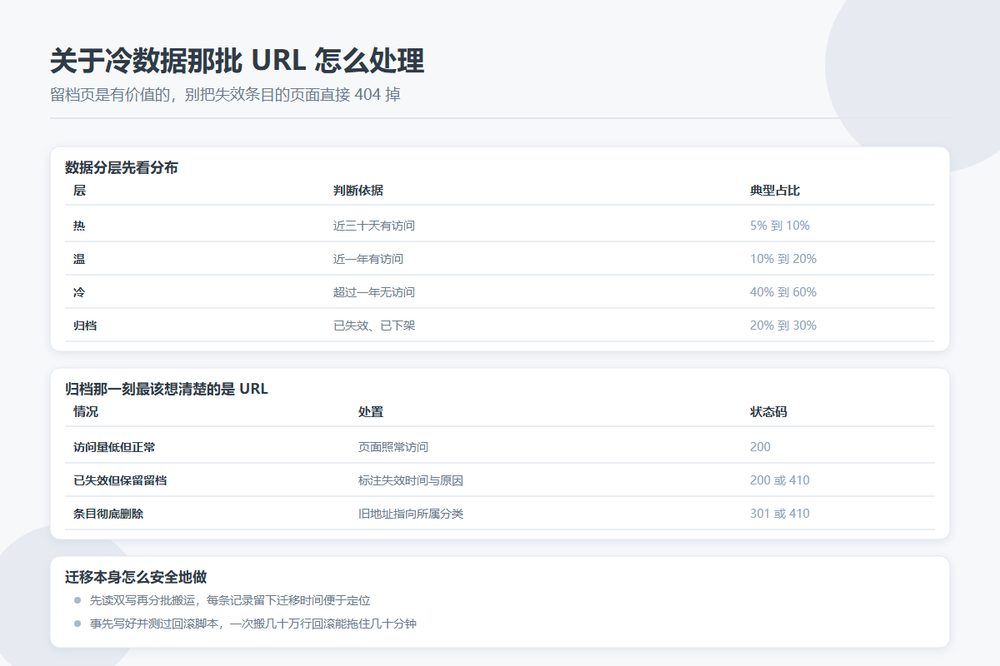
| 数据层 | 判断依据 | 典型占比 |
|---|---|---|
| 热 | 近 30 天有访问 | 5% - 10% |
| 温 | 近一年有访问 | 10% - 20% |
| 冷 | 超过一年无访问 | 40% - 60% |
| 归档 | 已失效、已下架 | 20% - 30% |
最后那部分通常是大头。已经下架的条目之所以还留在主表里,多半是因为「万一有一天要恢复」。这个想法没错,但没必要让它们占着主表的空间和索引。
几种做法,成本差很多
一、分区表
按月或者按状态做分区,冷数据落在单独的分区里。查询带分区键时能直接跳过。改造成本适中,对应用基本透明,适合单表千万行以内的情况。
二、拆历史表
把一年前的数据搬到 items_archive,主表只留活跃的。应用层需要在查询时判断要不要去查历史表。
这种方案的问题是分页和统计会变复杂——「总数」要查两张表,深分页要在两个表里做偏移。如果这类查询很多,维护成本会比较高。
三、把冷数据的详情字段移出去
这是我最推荐的做法,尤其适合目录站。列表页需要的字段很少:名称、域名、图标、分类、状态、更新时间。而详情页用到的长简介、历史快照、原始 JSON、抓取日志这些,可以单独放一张 items_detail 表。
主表瘦下来之后,索引变小、缓存命中率上升、备份变快,而应用层的改动仅限于详情页多一次关联查询——这个查询本身还有缓存可以挡。
这个方案的好处是不改变任何 URL 和数据归属,所有条目都还在,只是物理存储位置不同。回滚也容易,把字段搬回来就是了。
归档那一刻最该想清楚的:URL
数据可以搬走,URL 不能凭空消失。已经收录、已经被外链引用过的条目页,一旦归档后返回 404,等于之前积累的东西全废了。
三种处置方式对应三种情况:
| 情况 | 处置 | 状态码 |
|---|---|---|
| 站点正常,只是访问量低 | 页面照常访问,数据从归档/从表读 | 200 |
| 站点已失效但保留留档 | 保留页面,标注失效时间与原因 | 200 或 410 |
| 条目彻底删除 | 页面消失,有关的旧地址 301 到所属分类 | 301 / 410 |
第二种值得多说一句。留档页是有价值的:它记录了这个站点曾经存在、什么时候关停、为什么下线,对做网络变迁梳理的人来说是有效信息。这类页面不要随便 404 掉。
410 Gone 表示「这个资源曾经存在,现在已经永久移除了」,比 404 语义更准确。如果你确定这个页面不会再回来,用 410 而不是 404。
失效条目的归档要自动
人工判断什么时候该归档是不可持续的。定几条规则自动跑:
- 连续 N 次巡检失败且超过三个月的 —— 标记为疑似失效
- 疑似失效状态持续超过六个月的 —— 移到归档层,页面改 410 或保留留档页
- 页面沉寂三年零访问的 —— 详情字段移出主表
每条规则都要配一个例外:人工锁定的条目不参与自动迁移。有些条目浏览量不高但有战略意义(比如合作方要求保留的位置),加一个 lock 字段就够了。
迁移本身怎么安全地做
- 先读双写——新数据写两份,读先走旧位置,验证一段时间
- 分批搬运——一次五千到一万条,批次之间留出监控窗口
- 每条记录记 migrated_at——出问题能精确定位到哪一批
- 保留回滚脚本——把数据搬回主表的 SQL 提前写好测过
分批那条最重要。一次搬几十万行的操作一旦中途失败,事务回滚本身就能把库拖住几十分钟。小批次出问题影响面小,重试也快。
做完要看到什么变化
归档做完之后,至少应该观察到这几项:慢查询日志条目数下降、备份耗时缩短、热门列表页的 p95 响应时间稳定。
如果这几项都没变,说明瓶颈不在数据量上,要回头去看索引和查询语句。前面讲过的 «EXPLAIN 看哪四列» 那套流程在这儿依然适用——先定位再动手,别把归档当成万能药。