
JS 报错不只是用户看不见内容:目录站的前端异常监控该接进 SEO 排查
 J
前端错误日志在很多团队里属于「有人看,但没人当回事」的那类数据。报错率 0.3%,看着不高,开发说不影响主流程,就这么放着。
直到某天发现一批页面的收录状态不对劲,查了一圈才想起:搜索的渲染服务加载页面时,如果某个关键脚本在前面崩了,后面靠 JS 插入的内容全都不会出现。它抓到的就是那一版残缺的 HTML。
图片来源:网络,版权归原作者所有,侵权请联系删除
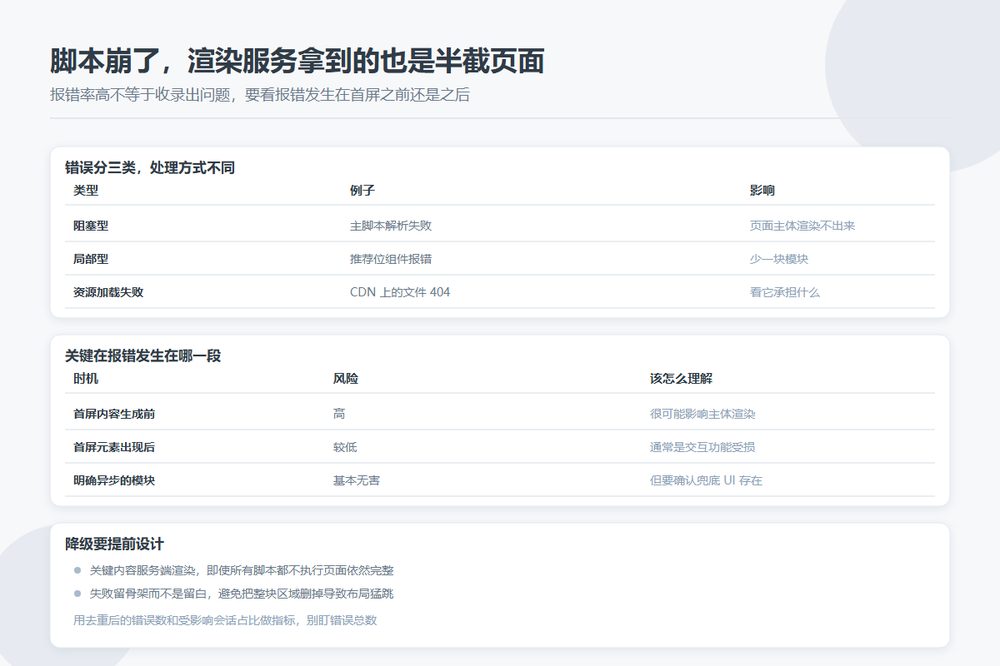
错误分三类,处理方式完全不同
| 类型 | 例子 | 影响 | 优先级 |
|---|---|---|---|
| 阻塞型 | 主脚本解析失败 | 页面主体渲染不出来 | 最高 |
| 局部型 | 推荐位组件报错 | 少一块模块 | 中 |
| 资源加载失败 | CDN 上的某个 JS 404 | 看它承担什么 | 看归属 |
第一类必须当天处理。它的用户侧表现是白屏或者只有头部导航,而这种现象在后端监控里完全看不到——服务器返回 200,日志一切正常。
第三类容易被低估。一个 404 的 JS 文件,如果它恰好负责渲染分类列表,那影响等同于第一类。所以资源加载失败不能单独按「资源」归类,要看它挂在哪条渲染链路上。
怎么判断是否影响了渲染产出
这里有个很容易搞混的点:错误率高不代表收录出问题。搜索引擎渲染的是最终 DOM,某些报错之后页面仍然完整——比如埋点脚本崩了,对用户看到的内容毫无影响。
判断的关键在于报错发生在首屏内容生成之前还是之后。三个粗略的分界:
- 报错在 DOMContentLoaded 之前 —— 高风险,很可能影响主体渲染
- 报错在首屏元素出现之后 —— 影响较小,通常是交互功能受损
- 报错来自明确标注为异步 / 延迟加载的模块 —— 基本无害,但要确认兜底 UI 存在
不要把「错误总数」当成告警指标,群控监测一个错误、因为某个用户装了某个插件,能一天刷出上万条。要用「去重后的错误数」和「受影响会话占比」两个指标。
第二个更有用。如果某个错误只影响 0.05% 的会话,而且集中在某个冷门浏览器版本上,那大概率是兼容问题,不是急需处理的事故。
Source Map 别传到生产环境
压缩后的 JS 报错堆栈是一堆 a.b.c 这样的短名字,没法看。要还原成原始行号需要 Source Map。但把 .map 文件公开放在生产环境有两个问题:源码泄漏,以及额外的传输开销。
正确做法是把 map 上传到错误监控平台,线上不保留可访问的 map 文件。上报的堆栈经平台还原,既拿到了可读信息,又不暴露源码。
另外要注意构建产物的版本号留痕。报错堆栈里带着文件名哈希,如果没有一个 mapping 记录「这个哈希对应哪次发布」,还原出来的行号也没法定位到哪次改动引入的。
和 Search Console 的数据对着看
这是最容易被忽略的一步。GSC 的「网页索引」报告里,某些页面状态(比如「已抓取但尚未编入索引」、部分 Rich Results 异常)有时候不是算法判断的结果,是渲染产出有问题。
具体做法是:把报告里出问题的 URL 批量提取出来,用渲染工具(GSC 的「检查网址」里的「测试实际网页」)跑一遍,看截出来的 DOM 里有没有本该出现的内容。如果缺了,再去错误平台里查这段时间、这个模板下有没有集中的报错。
命中率不算高,多数情况下两者没有关联。但只要遇到一次,这个排查通道的价值就回来了——因为这类问题用其他手段基本查不出来。
降级这件事要提前设计
既然脚本一定会偶尔崩,那就让崩了之后还有一个能看的版本。
- 关键内容服务端渲染——分类列表、条目名称、简介这些核心文字在 HTML 里就应该存在,不依赖 JS 填充
- 失败留骨架而不是留白——组件报错后显示占位框架,而不是把整块区域删掉,避免 CLS 猛涨
- 错误边界捕获到组件级别——一个非关键模块崩了不要拖垮整个页面
第一条是根本解。服务端渲染的好处不只是首屏快,更重要的是「即使所有 JS 都不执行,页面依然是完整的」。这一条做到了,前端错误对收录的影响就降到了最低。
告警怎么设
三条规则足够:
- 同一个去重错误,一小时内影响会话数超过基线三倍
- 出现任何一个新首次见到的阻塞型错误
- 关键 JS 或 CSS 资源的加载失败率超过 1%
第二条最重要。老错误的量变 通常只是流量波动,而「从没出现过的错误」意味着刚发过版本。把这个跟发布时间线对上,几分钟就能定位到是哪次部署。