
连接池打满之后:目录站那几个数据库连接参数,和它们发作时的症状
 连
这类故障最容易被误判的方向就是「优化查询」。因为现象看起来就是慢,于是有人去翻慢查询日志,翻了半天什么都没有——请求根本没走到执行那一步,它们在等一条空闲连接。
等连接的那段时间,是完全不计入 SQL 执行时间的。
图片来源:网络,版权归原作者所有,侵权请联系删除
一条连接到底占什么
MySQL 是每连接一个线程,加上这个会话自己的一批缓冲区(排序缓冲、连接缓冲、临时表大小这些),单连接的内存开销随配置在几 MB 量级。PostgreSQL 是每连接一个独立的后端进程,开销更实在。
默认值上,MySQL 的 max_connections 是 151,PostgreSQL 的 max_connections 是 100。这两个数字都偏保守,但反过来说,你把连接池设成 200 而数据库还是默认值,数据库就先撑不住了。
除了占用,还有一次性的建立成本:TCP 握手、身份认证、可能还有 TLS 协商。短连接模式下,一个本该 5 毫秒的查询,光打招呼的时间就比执行时间还长。
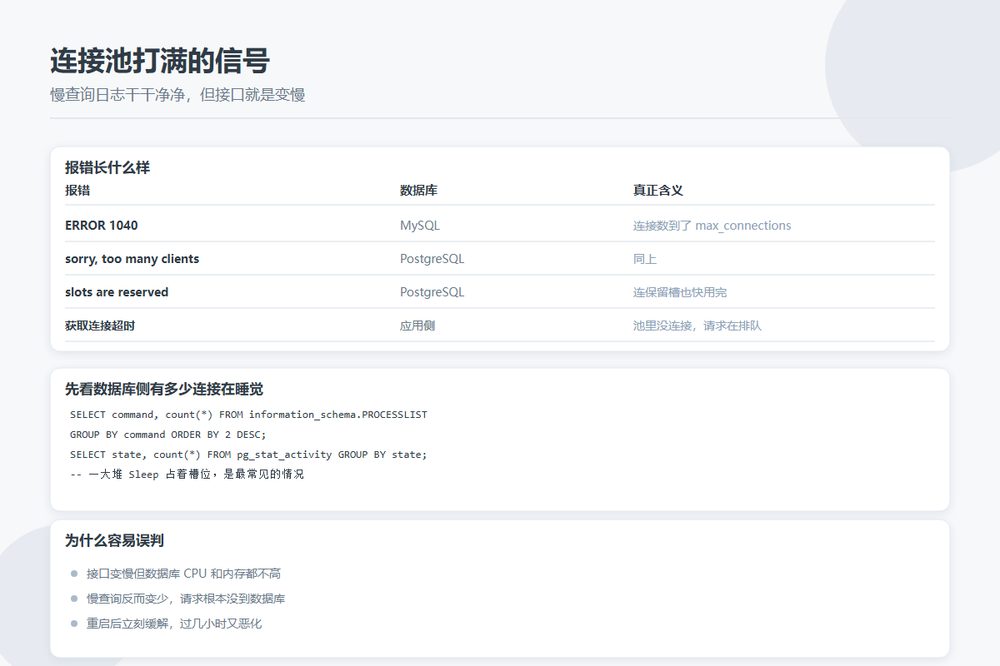
报错长什么样
| 报错 | 数据库 | 真正含义 |
|---|---|---|
| ERROR 1040: Too many connections | MySQL | 连接数到了 max_connections |
| FATAL: sorry, too many clients already | PostgreSQL | 同上 |
| remaining connection slots are reserved... | PostgreSQL | 连超级用户的保留槽也快用完了 |
| Connection is not available / 获取连接超时 | 应用侧 | 池里没连接,等待超时 |
注意最后一类:应用侧的报错往往先出现。数据库还没拒绝连接,应用这边已经在排队了。
为什么容易误判
四个典型症状,凑齐两个基本就能确认:
- 接口平均响应时间稳定上升,但数据库 CPU 和内存都不高。
- 慢查询反而变少了——请求根本没到数据库,自然没有慢查询。
- 日志里出现大量获取连接超时。
- 重启应用后立刻缓解,过几小时又恶化。
第四条几乎是个指纹。重启会清空池,连接重新慢慢积累,攒到上限又要几小时。如果是慢查询或者索引问题,重启不会有任何改善。
该先看哪三个数
第一个是应用侧的池指标:活跃连接数、等待连接的线程数。以 HikariCP 为例,通过 Spring Boot Actuator 可以直接读到 hikaricp.connections.active 和 hikaricp.threads.awaiting。后一个数只要长期大于零,就说明池已经不够用了。
第二个是数据库侧的实际连接数:MySQL 用 SHOW PROCESSLIST 或者查 information_schema.PROCESSLIST,PostgreSQL 查 pg_stat_activity。重点看有多少是 Sleep 状态——一大堆空闲连接占着槽位,是最常见的情况。
-- MySQL:看看有多少连接是在睡觉
SELECT command, count(*) FROM information_schema.PROCESSLIST
GROUP BY command ORDER BY 2 DESC;

-- PostgreSQL:活跃查询和等待事件
SELECT state, count(*) FROM pg_stat_activity GROUP BY state;
第三个是等待时长分布。应用侧记录「从申请连接到拿到连接」的耗时,这个数比响应时间更能说明问题——如果它在涨而 SQL 执行时间没变,瓶颈就在池上。
池大小怎么定
一个能用的算式:并发线程数 × 每个请求需要的连接数 + 预留。大部分目录站的请求,一个请求一条连接就够了,所以池大小基本等于应用层能同时处理多少请求。
三条硬约束:数据库的 max_connections 必须 ≥ 所有实例池上限之和(多实例部署时要乘实例数);连接获取超时不要太长,30 秒以内,别让线程无限期阻塞;连接的最大存活时间要小于数据库的 wait_timeout,否则会出现「应用以为连接还在,数据库已经断了」的周期性抖动。
另外一个很容易被忽略的参数是泄漏检测阈值。设一个比业务最长查询稍大的值,超时的连接会被记录下来,能直接定位到没归还连接的那段代码。
目录站特有的两个坑
第一个是循环里取连接。批量更新几百条条目时,如果在循环体内每次都申请一条连接,池瞬间就被占满。正确做法是取一条连接,循环里复用,用完归还。
第二个是后台任务和前台请求共用一个池。巡检、重建索引这类任务一次跑几千条,会把前台请求的连接全挤掉。给后台任务单独开一个池并限制上限,是成本最低的隔离方式。
排查顺序上,把「先看连接数」放在「先看慢查询」之前,能省掉很多无效的下午。