
告警响了之后往哪发:目录站的告警通道、降噪和值班这三件事
 告
大部分目录站的监控死在同一个地方:不是没接,是接完之后告警太多。第一天大家还认真看,第七天开始全部静音,第二十天连短信都不点开了。这时候有没有监控,区别只剩一张好看的图。
上一篇讲的是该盯哪几项指标,这篇讲指标越线之后的事——那条消息怎么发出去,谁会在半夜被叫起来,以及怎么让它不变成狼来了。
图片来源:网络,版权归原作者所有,侵权请联系删除
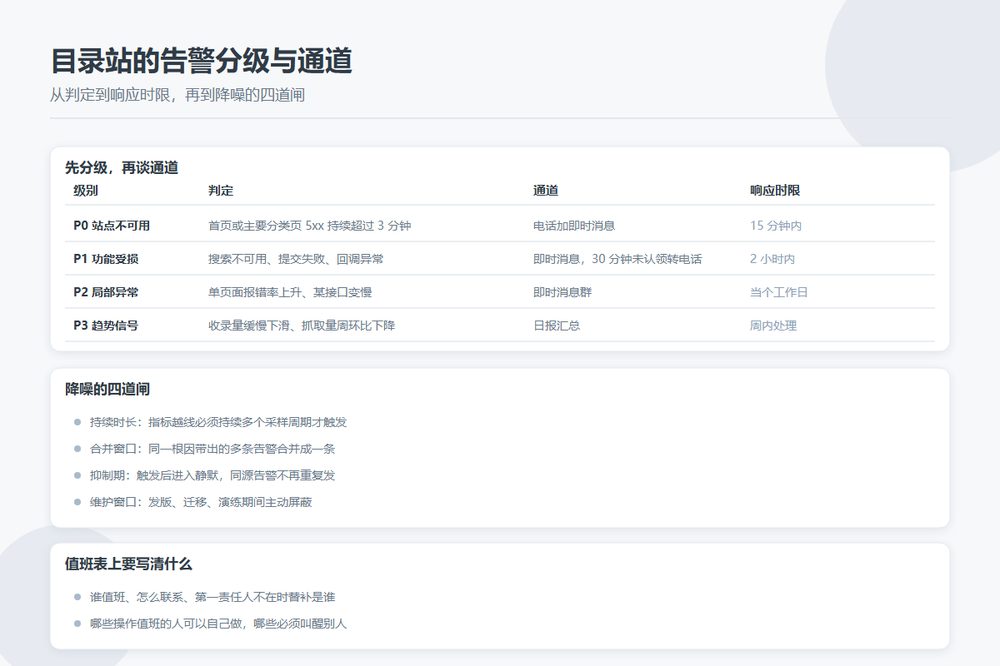
先分级,再谈通道
| 级别 | 判定 | 通道 | 响应时限 |
|---|---|---|---|
| P0 站点不可用 | 首页或主要分类页 5xx 持续超过 3 分钟 | 电话加即时消息 | 15 分钟内 |
| P1 功能受损 | 搜索不可用、提交失败、支付回调异常 | 即时消息,30 分钟未认领转电话 | 2 小时内 |
| P2 局部异常 | 单页面报错率上升、某接口变慢 | 即时消息群 | 当个工作日 |
| P3 趋势信号 | 收录量缓慢下滑、抓取量周环比下降 | 日报汇总 | 周内处理 |
级别判定的关键是「持续时长」这个维度不能省。一次 502 不算故障,连续三分钟的 502 才算。瞬时抖动直接进告警,等于给自己制造噪声。
收录相关的指标要单独放在 P3。它变化慢、不可逆、也不会自己恢复,塞进实时告警里只会被忽略,但放进日报里,每周看一次是能看出趋势的。
降噪的四道闸
- 持续时长——指标越线必须持续 N 个采样周期才触发,抖动被这一步滤掉大半。
- 合并窗口——同一个根因往往带出七八条告警,按服务或按页面合并成一条,正文里列出受影响范围。
- 抑制期——告警触发后进入一段静默,期间同源告警不再重复发,避免刷屏。
- 维护窗口——发版、迁移、演练期间主动屏蔽,这是最容易被漏掉的一道,而它恰恰能挡掉最多的噪声。
第四道闸要能提前预约。发版脚本跑起来的时候顺手调接口开一个 30 分钟的维护窗口,比事后在群里解释「刚才那是我们在发版」省事得多。
通道怎么排
通道不是越多越好,是每条告警都要有明确的下一个动作。即时消息适合需要讨论的告警,大家能在群里接话;电话只留给 P0,用滥了就没人接了;邮件适合日报和需要留档的东西。
升级路径必须写死。P0 发出去 15 分钟没人认领,自动升级给第二责任人,再 10 分钟升级到负责人。这条路径不能靠人自觉,得由系统走完。认领这个动作也要有反馈——点一下「我来处理」,告警就不再升级,同时也告诉其他人不用重复动手。
还有一条容易被忽略:告警消息里必须带排查入口。只写「首页 5xx 超阈值」,接的人还得自己去翻是哪个监控;带上图表链接、最近一次发版时间、相关日志入口,能省下好几分钟。
值班表上要写清什么
一张能用的值班表至少要写清:谁值班、值班期间怎么联系、第一责任人不在时的替补是谁、以及哪些操作值班的人可以自己做、哪些必须叫醒别人。
最后一条最重要。半夜三点被叫起来,最糟糕的情况不是问题难,是不知道自己有没有权限动手。把可自主操作的清单写下来(重启服务、回滚版本、切到备用机),值班的人心里有底,处理速度完全不一样。
事后那一步
每次 P0 之后留一页记录:什么时候发现的、谁接的、怎么定位的、最后怎么解决的、下次怎么更快。不用长,五分钟能写完。三个月之后回头看,会发现大部分故障都重复过两三次,而记录里早就写了怎么修。
没有这一步,监控就只是一条条推送,永远成不了经验。