
上线前自己爬一遍:目录站的自查抓取脚本该怎么搭
 上
改版上线那天,你会做的事大概是打开几个页面看看正不正常。首页、一个分类页、一个条目页,都没问题,收工。三天后收录量开始掉,你才知道有一批页面返回的是软 404。
人工抽查的覆盖率太低了。目录站动辄几千上万个页面,看十个页面正常说明不了什么。能覆盖全量的只有一个办法:自己写个脚本,把整站爬一遍。
图片来源:网络,版权归原作者所有,侵权请联系删除
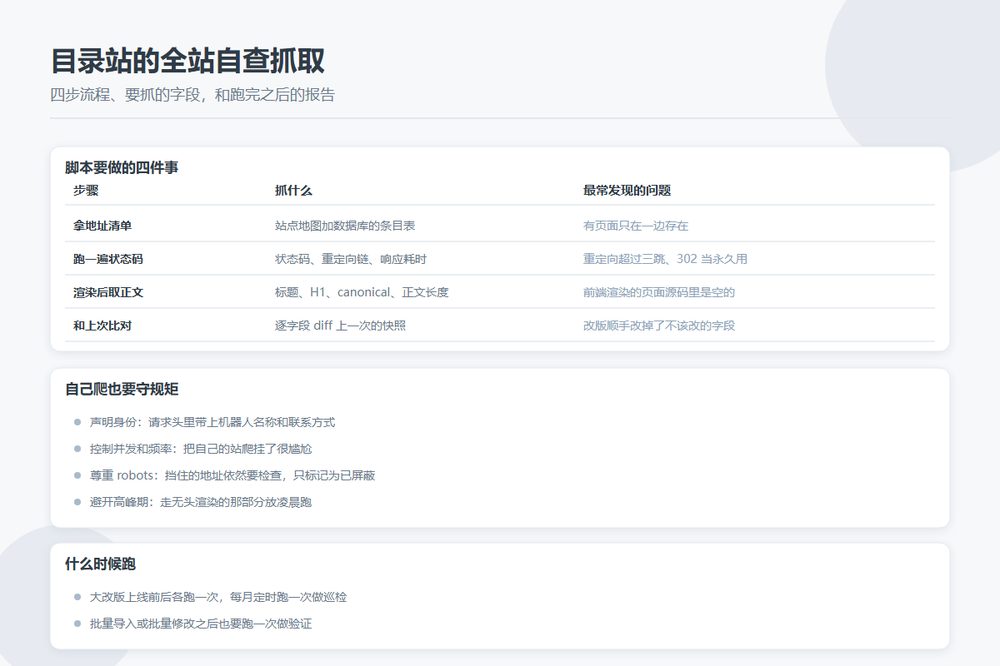
脚本要做的四件事
| 步骤 | 抓什么 | 产出 | 最常发现的问题 |
|---|---|---|---|
| 拿地址清单 | 站点地图加数据库里的条目表 | 待抓 URL 列表 | 两边对不上,有页面只在一边存在 |
| 跑一遍状态码 | 状态码、重定向链、响应耗时 | 状态码分布与重定向清单 | 重定向超过三跳、302 当永久用 |
| 渲染后取正文 | 标题、H1、canonical、正文长度 | 每页的字段快照 | 前端渲染的页面源码里是空的 |
| 和上次比对 | 逐字段 diff 上一次的快照 | 差异清单 | 改版顺手改掉了不该改的字段 |
第一步的地址清单别只从站点地图拿。站点地图里没有的页面不代表不存在,数据库里的条目表才是权威来源。两边做一次差集,经常能发现一批生成了但没提交、或者提交了但已经删掉的页面。
状态码那一遍要记录完整重定向链,不能只看最终结果。A 跳 B 再跳 C 最后到 D,返回 200,看起来没事,但链条太长本身就是要处理的信号。
渲染后取正文这一步不能省
如果页面内容靠前端脚本填充,直接请求拿到的 HTML 里主体是空的。这时候只看源码会得出「这页是空的」的错误结论,而只看浏览器又会得出「这页没问题」的错误结论。正确答案是拿渲染后的 DOM,用它来判断。
用无头浏览器跑一遍成本确实高,几千个页面全跑不现实。折中的办法是分层跑:全量用普通请求扫状态码和响应头,抽 5% 的样本页走无头渲染比对正文。样本要覆盖每种页面类型,别全抽同一个分类。
抽取的字段别贪多,四个够用:title、H1、canonical、正文字符数。这四个字段覆盖了绝大多数会造成收录变化的情况,字段太多反而淹没真正的差异。
自己爬也要守规矩
- 声明身份——请求头里带上自己的机器人名称和联系方式,日志里能查到是谁在爬。
- 控制并发和频率——并发别超过个位数,页面之间留一点间隔。把自己的站爬挂了是很尴尬的事故。
- 尊重 robots 但要分开看——robots 挡住的地址依然要检查,只是标记为「已屏蔽」,不要因为挡住了就当它不存在。
- 避开高峰期——放在凌晨跑,尤其是要走无头渲染的那部分。
跑完之后的那张报告
报告不用漂亮,能一眼看出问题就行。我习惯固定四块:状态码分布(各状态码多少条)、需要处理的清单(4xx、5xx、超长重定向链,每条带 URL)、字段变化清单(title 或 canonical 变了的页面,带新旧值)、以及与上次相比的新增和减少。
最后一块最有用。改版之后条目总数突然少了三百,多半是某个筛选条件写错了;突然多了两千,多半是把带参数的地址也生成进来了。这种变化看单个页面看不出来,看总数一眼就能发现。
什么时候跑
三个时机:大改版上线前后各跑一次做比对,每月定时跑一次做巡检,每次批量导入或批量修改之后跑一次做验证。前两个是例行,第三个最容易被跳过,也最容易出事。
脚本本身不难,半天能写完。真正花钱的是那台跑无头渲染的机器和每次跑完看报告的那十分钟,而这两样省下来的代价,是一次收录量下滑之后连续两周的排查。