
用大模型批量写条目简介:可控的三步流程,和必须留下的人工核对点
 用
目录站的简介是个尴尬的活:一条几十个字,几千条就是几万字;不写,条目页就是薄内容;写,人写不完。于是很多人想到了大模型。
用下来最常见的翻车方式不是文笔差,是编。模型会一本正经地写出「成立于 2015 年,服务超过百万用户」,而这个数字在对方官网的任何一页都找不到。这类内容发出去,用户的信任损失是小事,被对方指出造假的尴尬才是大事。
图片来源:网络,版权归原作者所有,侵权请联系删除
第一步:给模型划定事实边界
核心原则只有一句:模型能用的事实,只能是你在输入里给它的。超出输入范围的内容,它一旦生成就是编造,不管读起来多合理。
所以输入要结构化。别把整个网页丢给它让它总结,那等于允许它自由发挥。应该先由程序把事实抽成字段:
- 站点名称、所属分类、官网首页标题与首屏文字
- 备案主体(如果能查到)、域名注册信息里可公开的部分
- 站内已有的标签、同类条目的描述风格样本
- 字数区间、必须包含的信息点、禁止出现的表述
提示词里要明写一句:只使用以上信息,未提及的内容一律不写。这句话的效果比反复强调「请准确」好得多,因为它把任务从「创作」改成了「改写」。
第二步:限制输出结构
输出必须能解析。让它返回一段自由文本,后处理就变成了一场灾难;让它按固定字段返回,程序就能直接入库。
三个约束值得加:字数硬区间(比如 60 到 90 字,超出重写)、句式模板轮换(准备四五套开头方式随机分配,避免几千条简介一个腔调)、以及禁止词表(绝对化用语、承诺性表述、未提供的数字)。
句式轮换这一条特别容易被忽略。模型对同一类输入的默认输出高度同质,不做干预的话,同一个分类下的几百条简介读起来像一个人写的,重复度检测很容易判高。
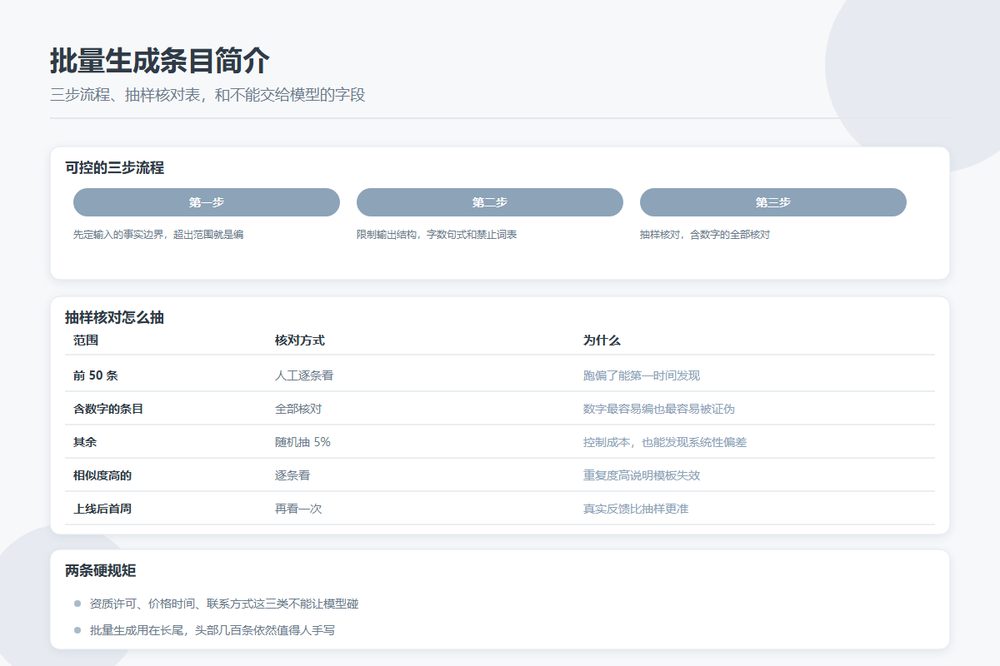
第三步:抽样核对怎么抽
| 范围 | 核对方式 | 为什么 |
|---|---|---|
| 前 50 条 | 人工逐条看 | 跑偏了能第一时间发现,避免全量返工 |
| 含数字的条目 | 全部核对 | 数字是最容易编、也最容易被证伪的部分 |
| 其余 | 随机抽 5% | 控制成本,同时能发现系统性偏差 |
| 相似度高于阈值的 | 逐条看 | 重复度高说明模板失效或输入太像 |
相似度检测要在入库前跑一遍。把新生成的简介和同分类已有条目比一遍,超过阈值(一般取 0.8 上下)就打回重写。几千条简介真正的风险不是单条质量,是整批长得一样。
三类绝不能让模型自由发挥的字段
- 资质与许可——有没有牌照、什么等级、谁发的,这类信息只能从官方渠道核实后填写,模型猜出来的后果最严重
- 价格与时间——多少钱、什么时候上线、多久更新一次,这些会变,也会被人拿来对质
- 联系方式与地址——编出来的电话和地址会让用户打到无关的人那里,属于实打实的骚扰
这三类字段应该从流程里直接摘出去,交给人工或者交给能核实的数据源,模型碰都不要碰。
要不要标注是 AI 写的
建议标。不是因为有硬性规定,而是因为标注成本极低而收益明确:用户知道这条简介是整理生成的,就不会把它当成官方承诺;对方发现自己站点信息有误的时候,沟通也顺畅一些。
标注方式可以很轻,在条目页底部或数据说明页里统一写一句「部分条目简介由工具辅助整理,如有出入欢迎纠错」,比逐条打标省事,效果一样。
一个提醒
批量生成解决的是量的缺口,解决不了质的差异。真正让目录站有价值的那些条目——头部的几百个、用户搜得最多的那些——依然值得人手写。把模型用在长尾上,把人用在头部上,这个分配比全交给模型或者全靠人写都现实。