
分类页该不该 noindex:我复查了一遍,发现之前关错了三个,也漏关了五个
 分
我以前对分类页的态度很简单:全放出去,多一个页面多一个入口。后来站上类目涨到两百多个,其中一批是当初为了收几站临时建的,常年只有三五个条目,页面打开就是几行字加一个「暂无更多」。
图片来源:网络,版权归原作者所有,侵权请联系删除
noindex 不是开关,是「下一次抓取时生效」
先把机制说清楚,因为后面所有判断都建立在它上面。
noindex 写在页面 HTML 里(或者 X-Robots-Tag 响应头里)。爬虫必须把页面抓下来,读到这个指令,才会在下一次处理时把它从索引里移除。
这带来两个后果。第一,如果 robots.txt 把这个页面挡了,noindex 永远不会被读到。页面会以「已被 robots.txt 阻止」的状态留在报告里,之前进索引的也出不来。第二,生效需要一次抓取,急不来,通常几天到两周。
所以两者的分工是清楚的:robots.txt 管「这一类 URL 别来抓」,noindex 管「这一个页面别收录」。批量处理用 robots,个别页面用 noindex。
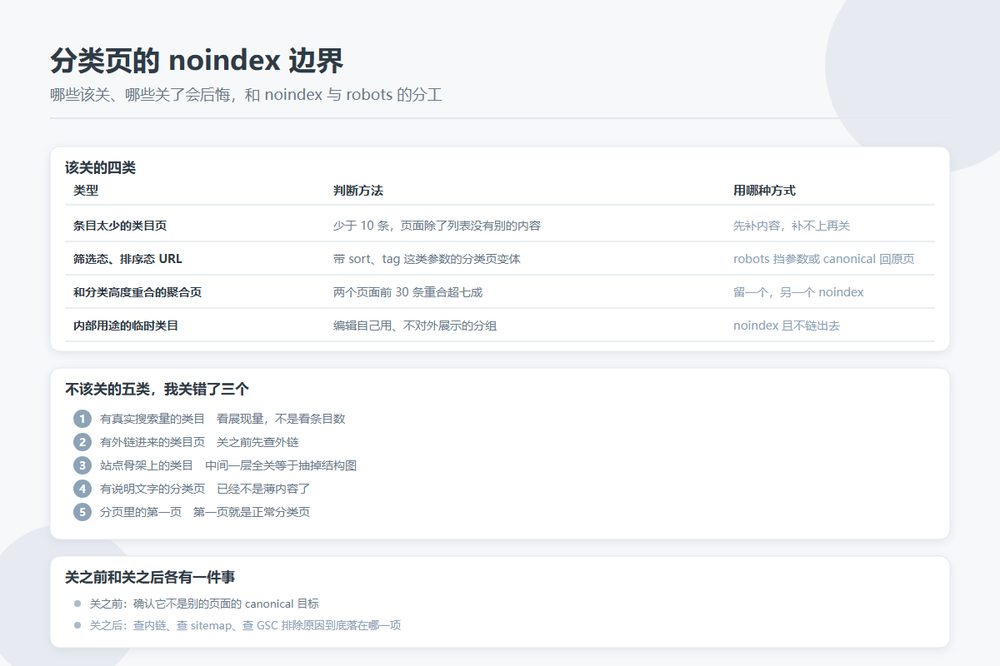
该关的四类
| 类型 | 判断方法 | 用哪种方式 |
|---|---|---|
| 条目太少的类目页 | 少于 10 条,且页面除了列表没有别的内容 | 先补内容,补不上就 noindex |
| 筛选态、排序态 URL | 带 ?sort=、?tag= 这类参数的分类页变体 | robots 挡参数,或 canonical 回原页 |
| 和分类高度重合的聚合页 | 两个页面前 30 条重合超七成 | 留一个,另一个 noindex 或 301 |
| 内部用途的临时类目 | 编辑自己用、不对外展示的分组 | noindex,并且别链出去 |
第一类最常见,也最容易被拖着。我的做法不是一上来就 noindex,而是先判断这个类目有没有真实需求:去搜索引擎搜这个类目名,看有没有人搜、结果里有没有你没收录的站。有需求就补内容再放;没需求就合并掉,别留着。
不该关的五类,我关错了三个
有真实搜索量的类目。条目少不代表没价值。有些垂直类目天然就只有十来个站,但搜那个词的人很精准。判断依据是 Search Console 里的展现量,不是条目数。我错关的第一个就是这种。
有外链进来的类目页。别人链到你的某个分类页,这个页面就承接了外部权重。noindex 之后这条链路就断了。关之前先查一下外链。
站点骨架上的类目。首页 → 大类 → 小类这条链上的页面,是爬虫理解你站结构的骨架。中间一层全 noindex,等于把结构图抽掉一块。
有内容的分类页。页面上除了列表,还有类目说明、收录口径、挑选建议——这已经不是薄内容了,别关。
分页里的第一页。有人把分页全部 noindex,连第一页一起关了。第一页就是正常的分类页,该留。
关之前和关之后各有一件事
关之前:确认这个页面不是其他页面的 canonical 目标。如果 A 页 canonical 指向 B 页,你又给 B 页加了 noindex,A 页的信号会一起掉进黑洞。
关之后:复查三处。页面本身是不是还在模板里被链到(比如面包屑、侧边栏的「相关分类」);站点地图里还有没有它;Search Console 的「已排除」里它最终落到了哪个原因下。第三点尤其重要——如果显示的是「已抓取但未索引」而不是「被 noindex 排除」,说明指令没生效或者页面还有其他问题。
一个我自己改掉的写法
曾经为了「保险」,我给一些页面同时写了 noindex 和指向首页的 canonical,还顺手在 robots 里挡了参数。三个信号互相打架:一个说别收录,一个说当成首页收录,一个说别来抓。这类页面在报告里的状态会非常混乱,而且你没法判断到底哪个生效了。
现在的原则是:一个页面只给一套明确的指令。要收录就别挡、别加 noindex、canonical 指向自己。要不收录就 noindex 且允许抓取,或者 robots 挡掉且接受它可能残留。别叠。
复查完那次,我关掉了五个该关的,把错关的三个放回来了。放回来之后其中一个在一周内重新进了索引,现在每个月能带来几十次点击——量不大,但那是白白丢掉的两个月。