
做了收藏夹之后,我的目录站多了一批没人看的页面:用户系统和收录的边界该怎么划
 做
目录站做了两三年,条目到了几千条,几乎都会冒出一个想法:给用户加个收藏夹吧,让人能把常用的站存下来。想法本身没错,我自己的站也做了。问题出在后面——收藏功能上线三个月后,我在 Search Console 的「已排除」里翻到一批从没见过的 URL,全是 /user/12345/favorites 这种形状,数量快赶上正经分类页了。
图片来源:网络,版权归原作者所有,侵权请联系删除
先说结论:收藏夹不该被收录,但它的价值不在搜索
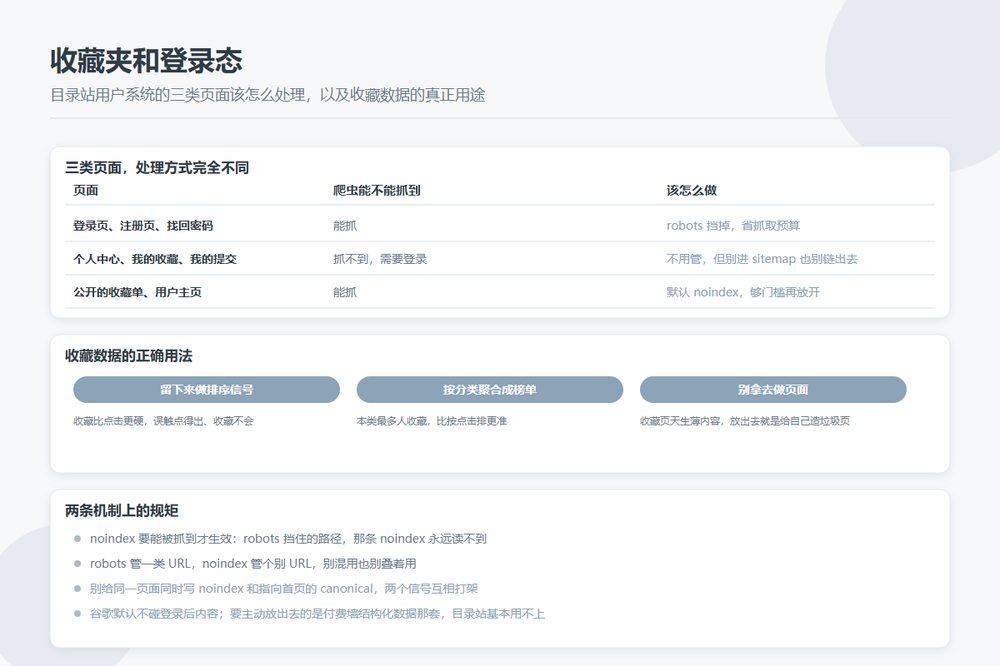
收藏夹页面天生是薄内容。一个用户存了六个站,页面上就是六个链接加一句「某某的收藏」,没有说明文字,没有编辑判断,跟分类页高度重复。这种页面放出去收录,等于自己给自己造了一批低质量页。
但收藏数据本身很有用,只是用途不在搜索侧。哪些条目被收藏得最多,是一个比点击更硬的偏好信号——点击可能只是误触,收藏是明确表态。把这份数据按分类聚合,就是一份天然的「本类最多人收藏」榜单,比按点击排出来的准。
所以正确的分工是:收藏行为留下来做排序信号,收藏页面不放出去。这两件事很多人混在一起做,结果既污染了索引,又没拿到那份数据。
登录后内容的官方口径:默认抓不到
谷歌在抓取文档里把这件事说得挺直白:如果页面在开放网络上访问不到,比如需要登录才能看,那抓取工具同样访问不到。注意用词是「默认」,不是「绝对」。
它的另一层意思是:你不需要为「爬虫看不到我的个人中心」做任何额外动作,本来就看不。真正需要动作的是反过来——你希望某些登录后内容被收录。那种情况有专门的付费墙结构化数据(isAccessibleForFree 配 hasPart 的 CSS 选择器),作用是把付费内容和伪装区分开,免得被当成 cloaking。目录站基本用不上这套东西,除非你把收藏榜单做成了付费可见。
这里有个容易做反的地方。很多人为了让爬虫「别来」,给个人中心加了 noindex。加了没坏处,但意义不大——爬虫本来就进不去。真正该做的是别让这些 URL 从公开页面被链到,以及别把它们写进站点地图。
三类页面的处理顺序
| 页面 | 抓取状态 | 该怎么做 |
|---|---|---|
| 登录页、注册页、找回密码 | 可抓 | robots.txt 挡掉,省抓取预算;这类页面没有搜索需求 |
| 个人中心、我的收藏、我的提交 | 抓不到(需登录) | 什么都不用做,但别放进 sitemap,别从导航链出去 |
| 公开的收藏单 / 用户主页 | 可抓 | 默认 noindex;达到门槛再考虑放开 |
第三类是最容易失控的。有些站为了社区氛围,把用户主页做成公开页面,还带一个 SEO 友好的 URL。这类页面一旦放出去,数量会随注册量线性增长,而内容质量完全由用户决定。我的做法是默认全部 noindex,只有同时满足下面三条才自动放开:收藏条目不少于 15 条、有用户自己写的一段说明、注册时间超过一个月。满足这三条的其实没几个,但那几个页面确实有内容。
一个机制上的坑:noindex 需要页面能被抓到
这条得单独讲,因为做错的人不少。noindex 是写在页面里的,爬虫得先把页面抓下来才能读到它。如果你同时在 robots.txt 里把这个路径挡了,爬虫根本不会来,那条 noindex 永远不会被读到,页面会以「被 robots.txt 阻止」的状态留在报告里,URL 也不会从索引里消失(如果它之前已经进去了)。
所以这两件事的分工是:robots.txt 用来挡「一类」URL,noindex 用来处理「个别」URL。想让整批 /user/ 路径不被抓,用 robots 的 Disallow: /user/。某一个已经被收录的收藏单想单独撤下来,给它 noindex,同时别挡 robots,等爬虫下次来读到它。
还有个更常见的错:给一个页面同时加了 noindex 和指向首页的 canonical。两个指令互相打架,一个说别收录,一个说收录成首页那个样子。这种页面在处理上是不可预测的,别这么写。
用户系统的真实成本,在功能之外
做收藏夹的技术量不大,真正耗人的是后面那些:找回密码的邮件送达、垃圾注册的清理、用户要求删除账号时的数据处理、隐私政策里要写清楚收集了什么。这几项任何一项没做好,都会在某个时间点变成麻烦。
我的建议是:如果站上连稳定的回访用户都还没攒起来,先别做。用「最近浏览」的本地存储挡一阵子,等日均回访到了几百人级别再上账号系统。上早了,维护成本吃掉的精力比它带来的留存多。
等真做了,记得把收藏数据用起来——不是拿去做页面,是拿去做排序。这份数据是你用真金白银的服务器换来的,别只躺在数据库里。