
去抓对方网站的时候,那个超时到底该设多少
 去
自己网站的接口慢了可以优化,去请求别人的网站慢了只能干等。目录站的巡检队列卡住,多数时候不是对方挂了,而是有一批请求在无限期地等一个永远不会来的响应。
图片来源:网络,版权归原作者所有,侵权请联系删除
三种超时不是一回事
很多 HTTP 库只给一个 timeout 参数,但连接阶段和读取阶段的风险完全不同:
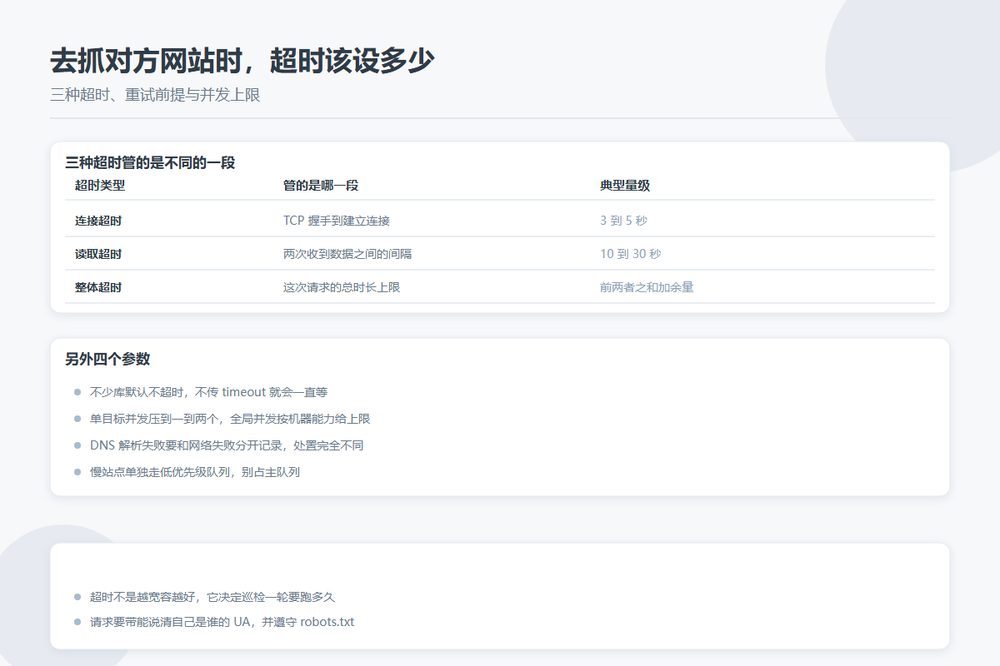
| 超时类型 | 管的是哪一段 | 典型量级 |
|---|---|---|
| 连接超时 | TCP 握手到建立连接 | 3 到 5 秒,连不上通常就是真连不上 |
| 读取超时 | 两次收到数据之间的间隔 | 10 到 30 秒,取决于对方页面大小 |
| 整体超时 | 这次请求的总时长上限 | 前两者之和再加一点余量 |
只设读取超时不设连接超时,对方防火墙静默丢包的那类主机会把连接挂到系统层面超时为止。只设连接超时不设读取超时,对方慢慢吐一个字节、每分钟吐一点,请求照样能挂住一小时。两个都要有,再加一个兜底的整体上限。
还有一条必须写进代码规范:不少库默认是不超时的。Python 的 requests 不传 timeout 就会一直等,这种写法在批处理里跑一晚上,第二天早上队列还是满的。
重试的前提是幂等
抓取类请求基本都是 GET,重试在语义上是安全的,但有两个条件:次数要有上限,间隔要退避。同一个目标连续失败三次之后就该放弃并记录下来,让下一轮巡检再来。
提交类的请求——比如回调对方的接口、推送条目状态——重试就必须先有幂等键,否则对方可能处理两遍。这一条上一篇讲异步任务时说过,在出站方向上同样成立。
并发不是越大越好
巡检队列常见的调参思路是"加并发",加到某个点之后整体反而变慢:连接数上去了,每个连接分到的带宽下降,读取超时集中触发,失败率上升,然后重试又放大了流量。
更稳的做法是分两层限制:单目标的并发控制在很小的值(一到两个),避免把对方小站打挂,这也是基本的礼貌;全局并发按机器能力给一个上限,用连接池复用连接,别每个请求都重新握手。
DNS 那一段也要单独想
抓对方站点时 DNS 解析失败是很常见的一类错误,尤其是那些刚换了 NS、或者域名已经过期但记录还在的站点。两个建议:解析结果在进程内缓存一小段时间,别每个请求都查一次;解析失败要和网络失败区分开记录,因为这两类的处置完全不同——前者通常意味着条目该进失效队列了。
超时的取值决定队列能跑多快
这几个参数凑在一起,直接算出巡检吞吐。假设 5000 个条目、单目标并发 1、全局并发 20、平均耗时 3 秒,一轮大约十几分钟;把读取超时从 10 秒放宽到 60 秒,只要有一成站点是慢的,这一轮就会被拖到一小时以上。
所以超时不是越大越宽容,而是你在给"慢的站点"分配多少耐心。目录站的做法通常是分档:正常巡检给一个较短的超时,超时的一律记进慢站点名单,用单独的低优先级队列在夜里慢慢重试,不占用白天的主队列。
最后别忘了那两个头
出站请求要带能说清自己是谁的 User-Agent,里面放上站点名和联系方式,方便对方管理员来问;同时遵守对方的 robots.txt。这两个是规矩问题,不是性能问题,但被投诉封 IP 之后,性能也就无从谈起了。
把超时当作配置项写进配置中心,而不是散落在各处的魔法数字。哪天队列又堵了,你能一眼看出是谁在拖。