
rel=next/prev 早就不是索引信号了:目录站的分页现在靠什么被走完
 r
2019 年 3 月 21 日,谷歌的 John Mueller 在社交平台上说了一句很随意的话:我们发现自己已经好几年不用 rel=next/prev 做索引了,干脆把文档删掉吧。官方账号跟着宣布正式退役。
这句话发出来的时候,一大批 SEO 清单还是围绕这两个标签写的。七年过去,仍有模板在输出它们。
图片来源:网络,版权归原作者所有,侵权请联系删除
留着还是删掉
结论是:已经在输出就不用改,还没输出也不用专门去加。
谷歌那边,Mueller 在第二天的答疑里说得很清楚,他们靠的是内链——"we use the internal links"。也就是说,分页序列是被普通链接走出来的,不需要专门的标记。当时也有工程师补了一句,说这些标签还有无障碍和其他用途,没必要特意删掉。
区别在于别的引擎:Bing 当时表示仍把它们当作页面发现和结构理解的提示,只是不合并索引、也不进排序模型。所以留着不算错。
真正决定能不能走完的是点击深度
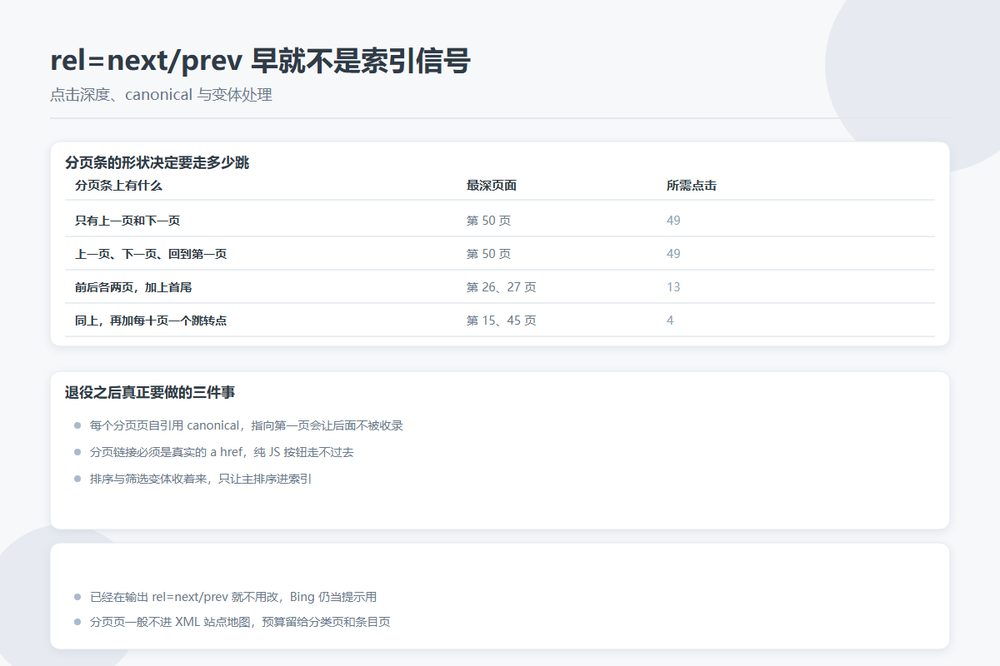
既然靠链接,那分页条的形状就决定了爬虫要跳多少下才能到底。拿一个有 50 页的分类页做算术,从第一页出发到最深那一页需要多少跳:
| 分页条上有什么 | 最深页面 | 所需点击 |
|---|---|---|
| 只有上一页和下一页 | 第 50 页 | 49 |
| 上一页、下一页、回到第一页 | 第 50 页 | 49 |
| 前后各两页,加上首尾 | 第 26、27 页 | 13 |
| 同上,再加每十页一个跳转点 | 第 15、45 页 | 4 |
这张表里有个反直觉的地方:"回到第一页"那个链接对深度一点帮助都没有,它的价值在别处。真正把深度从 49 压到 4 的,是最后一页和几个固定跳转点,代价只是分页条上多几个链接。
爬虫要爬完前一个 URL 才能知道下一个 URL 存在,所以每一跳都是真实的等待。目录站条目多、分页深,这个账必须算。
canonical 指向自己,不要指向第一页
这是退役之后最容易犯的错,而且是致命的那种。把第 2 页的 canonical 指向第 1 页,等于告诉搜索引擎这两页内容一样,后面那 49 页的条目可能永远不被收录。
正确做法:每个分页页自引用 canonical。除非你有一个真实存在的"查看全部"页,那才把各分页指向它。另外,分页页的链接必须是真实的 <a href>,纯 JS 按钮加载更多的那种,爬虫走不过去。
哪些变体不该收
分页本身可以收,但排序和筛选的变体要收着来。按热度、按时间、按评分排序的 URL,内容集合一样只是顺序不同,全放出来会造出一堆近重复页。目录站的常规处理是只让主排序进索引,其余变体 canonical 到主排序或者不放链接。
还有两条实操经验:分页页一般不进 XML 站点地图,它们可索引但不是优先项,把预算留给分类页和条目页;分页页的标题和描述带上页码做区分,避免后台里刷出一片重复的标题警告。
别忘了用户真的会用分页条
最后说个和技术无关的点。谷歌当年那句"研究表明用户更喜欢单页内容"被引用得很多,但它的原话还有后半句——分多页对搜索来说也没问题,按对你用户最好的方式做。
目录站的分类页动辄几百个条目,硬压成一页只会让 DOM 膨胀、首屏变慢,那是另一个已经写过的问题。分页该分就分,把分页条做全一点就行。
标签退役这件事真正的提醒是:别把站点结构寄托在某一个标记上。链接能走通,标记只是锦上添花;链接走不通,什么标记都救不了。