
sitemap 里躺着一堆早就不存在的页面:改版之后该做的那次对账
 s
有次帮人看站,顺手打开 sitemap 索引,里面挂着一个两年前的分片,列的全是旧结构的地址,爬过去一律 404。他说换程序的时候「忘了删」。这类残留不会立刻出事,但它每天都在消耗抓取配额,而且会让爬虫对这个站点的地址清单失去信任。
图片来源:网络,版权归原作者所有,侵权请联系删除
先记住三条硬规则
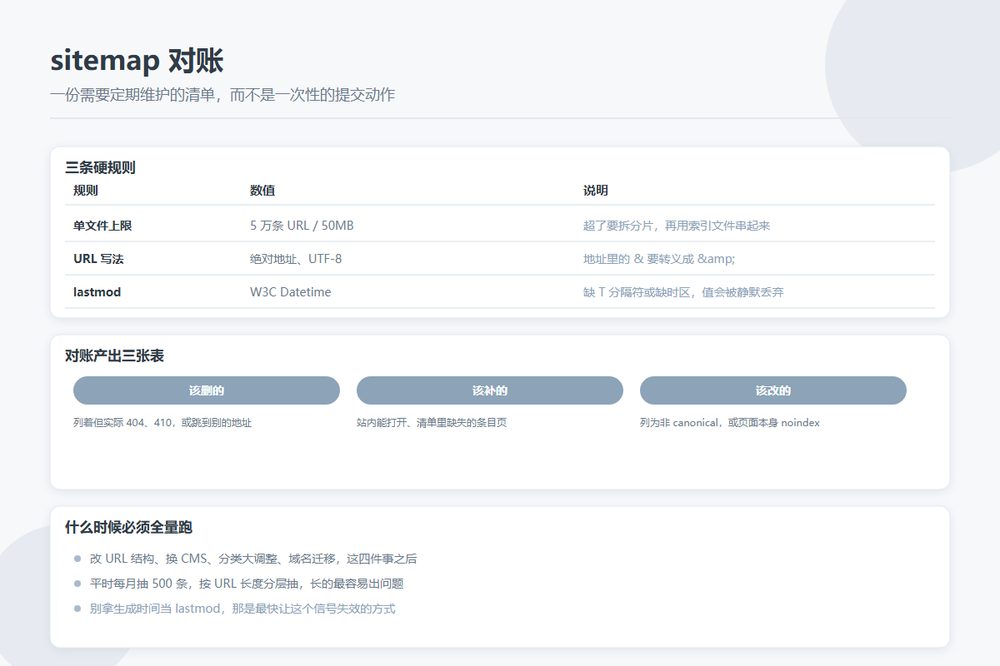
| 规则 | 数值 | 说明 |
|---|---|---|
| 单文件上限 | 5 万条 URL / 50MB 未压缩 | 超了要拆分片,再用索引文件串起来 |
| URL 写法 | 绝对地址、UTF-8 编码 | 地址里的 & 要转义成 & |
| lastmod 格式 | W3C Datetime | 缺 T 分隔符或时区会被静默丢弃 |
规则之外还有一条认知:提交 sitemap 只是提示,官方明确说了不保证抓取、也不保证收录。它的价值在于「告诉爬虫有哪些地址存在」,而不是「让这些地址进索引」。
lastmod 只在一种情况下有用
官方文档的原话大意是:只有当你提供的时间一致且可核实(比如和页面的实际修改时间对得上)时,才会被采用。换句话说,它不是一个可以随便填的字段。
最常见的自毁方式是每次生成 sitemap 都把当前时间写进所有 URL 的 lastmod。生成脚本跑得越勤,这个信号废得越快。更糟的是,一旦被判定不可信,恢复信任要很久。
另一个被忽略的事实:priority 和 changefreq 这两个字段早就被忽略了。很多插件还在生成它们,不影响什么,但别花时间去调那些数值。
四类不一致,成因各不相同
- sitemap 有,站上没有。改版、删条目、合并分类之后没清理。状态码可能是 404、410,也可能是 301 到别处。
- 站上有,sitemap 没有。这类叫孤岛页,通常来自分页深处、筛选页、或者程序自动生成但没进清单的页面。它们只能靠站内链接被发现。
- sitemap 里有不该被索引的。页面自己带 noindex,或者被 robots.txt 屏蔽,却还在 sitemap 里列着,等于让爬虫去撞墙。
- sitemap 里列的不是正主。同一个条目的带参地址、大小写变体、末尾斜杠两种写法同时出现,等于请爬虫自己挑一个。
对账怎么做:四步产出三张表
这件事写个脚本就能做完,不需要买工具。
第一步,把 sitemap 索引展开,拉出全部 URL 清单。第二步,对每条 URL 发 HEAD 请求,记录状态码和最终跳转到的地址。第三步,抽样抓页面里的 canonical 和 meta robots。第四步,和数据库里的条目表做集合运算。
输出三张表:
| 表 | 内容 | 处理 |
|---|---|---|
| 该删的 | 已在 sitemap 里但返回 404 / 410 / 跳转到别的地址 | 从生成逻辑里剔除,别手工改文件 |
| 该补的 | 站内可访问但 sitemap 缺失的条目页 | 补进生成逻辑,同时检查内链是否能到 |
| 该改的 | 列为非 canonical 地址、或页面本身 noindex 的 | 统一成规范地址,或从 sitemap 移除 |
什么时候必须做这件事
四种时机:改 URL 结构、换 CMS 或主题、分类大调整、域名迁移。这四件事都会产生大批新地址和废弃地址,对账能把残留一次性清掉。
平时不用全量跑,每月抽 500 条核一次状态码和 canonical 就够。抽样有个技巧:不要顺序抽,按 URL 长度排序后分层抽,长地址往往是最容易出问题的那批。
两件别做的事
一是别把 sitemap 当成「全部页面清单」,把筛选页、标签页、搜索结果页都塞进去凑数量。清单越杂,爬虫对这个清单的信任越低。
二是别为了让 sitemap 条数好看,把一页拆成假分页,每条只有一个条目。用户点进去要翻十几页,爬虫也会很快识别出这是低质分页。
把 sitemap 当成一份需要定期维护的清单,而不是一次性的提交动作,很多索引问题会提前消失。