
测试站被搜索引擎收录了:目录站的预发布环境该怎么隔离
 测
新模板上线前,我们习惯先丢到一台测试机上给产品和运营过一遍。域名通常是 staging.example.com 或者 test.example.com,随手解析一下就能访问。麻烦就出在这里:这台机器谁都能打开,包括搜索引擎。
等你在搜索结果里看到自己测试站的条目页时,抄袭站可能已经把它整站搬走一遍了。更糟的是,测试站和正式站内容高度重合,正式站那个页面反而可能被判成重复内容。
图片来源:网络,版权归原作者所有,侵权请联系删除
先说结论:robots.txt 挡不住
这是最反直觉的一点。很多人的第一反应是在测试站的 robots.txt 里写 Disallow: /,然后觉得完事了。
谷歌官方在 robots.txt 介绍文档里说得很清楚:被 robots.txt 屏蔽的网址,如果网上别的地方有链接指向它,仍然可能被编入索引。也就是说,robots.txt 只管抓不抓,不管收不收。只要有人(或者你自己的正式站、你的 sitemap、某个监控工具)链了这个地址,它照样能出现在搜索结果里,只是显示成「没有可用信息」的那种光秃秃的结果。
更麻烦的是,robots.txt 屏蔽和 noindex 是互相打架的。noindex 生效的前提是爬虫能抓到这个页面、读到那行 meta 标签。你先用 robots.txt 把门关了,爬虫就永远看不到 noindex,这条指令等于没写。谷歌在「使用 noindex 阻止索引」文档里专门点了这一点。
另外一条:谷歌不支持在 robots.txt 文件里写 noindex 规则。这么写是无效的。
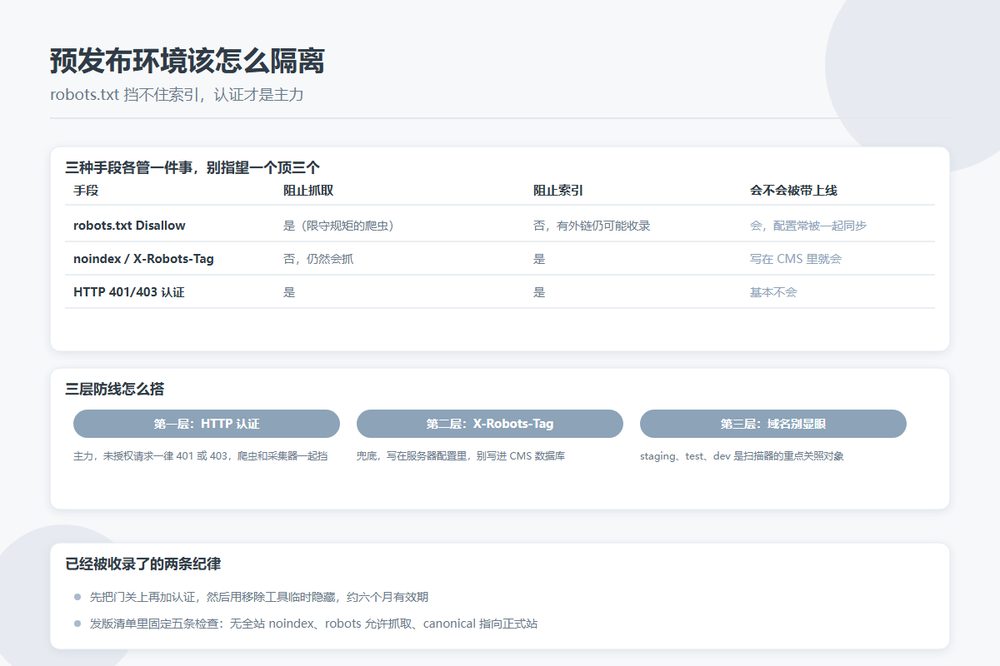
robots.txt 管抓取,noindex 管索引,HTTP 认证管访问。三件事,别指望一个顶三个。
三层防线怎么搭
第一层:HTTP 认证,这是主力
没有凭据的请求一律返回 401 或 403。可以放在 nginx 上,可以放在 CDN 上,也可以用托管平台自带的部署保护。这一层的好处是它同时解决了抓取和索引,顺带把采集器和竞品也挡在外面。
谷歌在「移除信息」相关文档里的态度是:限制页面访问,既能让该看的人看到,又能阻止 Googlebot 和其他爬虫访问。这是唯一一个从源头上解决问题的办法。
第二层:X-Robots-Tag 响应头,做兜底
在服务器配置里给整个测试站加一行:
X-Robots-Tag: noindex, nofollow用响应头而不是 meta 标签,有两个实际好处:一是非 HTML 资源(PDF、图片、下载包)也能覆盖到,这些文件根本没地方写 meta;二是它写在服务器配置或环境变量里,不会因为把数据库从测试环境拷到生产环境而被带过去。这一点非常关键,很多事故就是这么来的:noindex 开关存在 CMS 数据库里,某次为了同步数据把库倒过来,正式站整站 noindex。
第三层:域名本身就别暴露
能用内网域名就不用公网域名,能用随机前缀就别用 staging 这种一眼能猜到的名字。staging、test、dev、preview 这几个词是扫描器的重点关照对象。
三种手段的实际效果对比
| 手段 | 阻止抓取 | 阻止索引 | 会不会被带上线 |
|---|---|---|---|
| robots.txt Disallow | 是(仅限守规矩的爬虫) | 否,有外链仍可能收录 | 会,配置文件常被一起同步 |
| meta noindex / X-Robots-Tag | 否,仍然会抓 | 是 | 写在 CMS 里就会,写在服务器配置里不会 |
| HTTP 401/403 认证 | 是 | 是 | 基本不会 |
已经被收录了,按这个顺序清
顺序错了会白等一个月。
- 先把门关上。加 HTTP 认证,所有未授权请求返回 401 或 403。这一步不做,后面都是空的。
- 把测试域名单独验证成一个 Search Console 资源。子域名用 DNS 验证最省事。不验证你就没有移除工具可用。
- 用移除工具临时隐藏。按前缀提交,能最快让它们从结果里消失。注意这是临时措施,官方口径大约六个月。
- 等认证或 noindex 生效后被永久清掉。移除到期之前, crawler 重新访问会发现这些地址已经读不到内容,索引自然掉光。
- 找到并删掉所有指向测试站的链接。包括正式站正文里残留的、sitemap 里的、监控告警邮件里带的、以及第三方工具生成的。这一步最烦,但不做的话地址还会被反复发现。
- 别急着做 301。测试站页面如果确实拿到了流量和外链,可以把它们 301 到对应的正式站地址;如果只是一堆没人访问的测试页,让它掉光更干净。
反过来的一次事故:把测试站设置带上线
镜像方向的翻车同样常见。站上线了,生产环境还挂着测试站的 noindex、密码或者 robots.txt 全站禁止,自然流量第二天直接归零。
发版清单里应该固定这几条检查:
- 关键模板的页面源码和响应头里没有全站 noindex
- 生产环境的 robots.txt 允许抓取
- canonical 指向正式站地址,不是测试站地址
- 全站链接和 sitemap 里搜不到测试站主机名
- 用网址检查工具看一眼首页,确认看到的是线上版本
这几条写成脚本,每次发版跑一遍,比人肉检查靠谱得多。
目录站尤其容易踩的两个点
一是条目截图服务。很多目录站会跑无头浏览器给条目生成预览图,测试环境里跑的时候,那些临时图片地址、临时页面很可能挂在公网路径下,一样会被抓。
二是预览部署。现在的托管平台基本都会给每个分支生成一个预览地址,默认公开。这个开关一定要关掉,或者至少确认它带部署保护。
说到底,隔离这件事没有银弹,靠的是「认证做主力、响应头做兜底、域名别太显眼」这三件事同时成立,再加一条发版检查习惯。