
AI 爬虫进 robots.txt 之后:该拦的是训练,不是搜索
 A
这两年最常被问到的一个配置问题是:“我要不要把 AI 爬虫全禁了?”
问这话的人通常把 AI 爬虫当成一个整体。但它们分工差得很远,一刀切的结果往往是:你以为挡住了内容被拿去训练,实际上挡掉的是用户在 ChatGPT 里搜到你网站的机会。
图片来源:网络,版权归原作者所有,侵权请联系删除
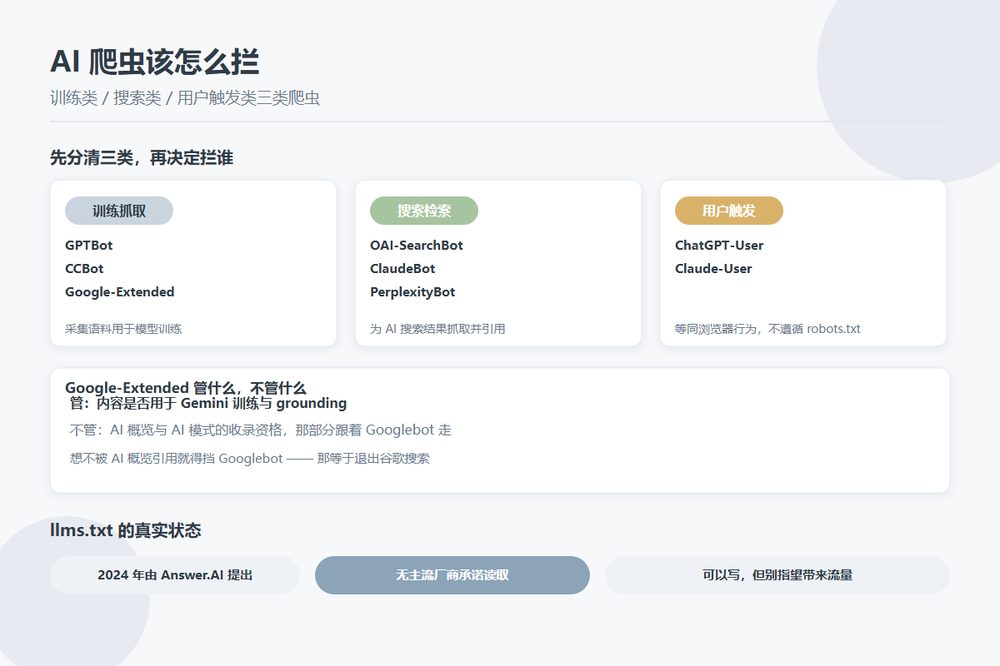
先分清三类爬虫
| 类别 | 代表 | 作用 | 是否遵循 robots.txt |
|---|---|---|---|
| 训练抓取 | GPTBot、CCBot、Google-Extended | 采集语料用于模型训练 | 是 |
| 搜索检索 | OAI-SearchBot、ClaudeBot、PerplexityBot、GoogleOther | 为 AI 搜索结果抓取并引用 | 是 |
| 用户触发 | ChatGPT-User、Claude-User | 用户对话中实时打开某个页面 | 否(等同浏览器行为) |
第三类要单独说:它们不是爬虫,是用户在对话里要求“打开这个链接”,请求由系统代为发出。这跟有人用浏览器点开你的页面没有区别,也不受 robots.txt 约束。所以你在 robots.txt 里禁了 GPTBot,用户在 ChatGPT 里问起你的站,页面照样会被打开。
Google-Extended 管什么,不管什么
这是误解最集中的一条。Google-Extended 控制的是内容是否用于 Gemini 的模型训练和 grounding,它不影响 AI 概览和 AI 模式的收录资格,那部分跟着 Googlebot 走。
换句话说:你禁掉 Google-Extended,内容不进 Gemini 训练语料,但你的页面该出现在 AI 概览里还是会出现,因为判断依据来自谷歌既有的搜索索引。想彻底不被 AI 概览引用,得把 Googlebot 也挡了——那等于退出谷歌搜索,代价和收益完全不成比例。
目录站该怎么配
对靠搜索流量活着的目录站,我的建议是分开处理:
- 放行:OAI-SearchBot、ClaudeBot、PerplexityBot、GoogleOther。这些是用户在 AI 里搜到你的通道;
- 可拦:纯训练类如 CCBot,以及你确实不想供训练的厂商爬虫;
- 想清楚再拦:GPTBot。它早期是纯训练爬虫,现在同时支撑 ChatGPT 的搜索检索,拦了会连带影响搜索曝光。
还有个最常见的坑:先去看 User-agent: * 那一组有没有 Disallow: /。很多站是 CMS 默认生成或早年随手写的,通配组一挡,后面你给 AI 爬虫单独写的 Allow 全都不生效。
llms.txt 现在是什么状态
llms.txt 是 2024 年由 Answer.AI 的 Jeremy Howard 提出的一份提案:在站点根目录放一个纯文本文件,用 Markdown 列出站点最重要的页面和简短说明,供语言模型快速了解这个站。
要说实话的是:到目前为止,没有任何一家主流 AI 厂商公开承诺会读取它。OpenAI、Anthropic、Perplexity 都没确认过,谷歌方面更是明确表示不依赖这个文件。实践层面的测量也支持这个判断——多数站点的服务器日志里,llms.txt 被请求的频率远低于 robots.txt 和 sitemap。
那还写不写?我的看法是写,但别指望它带来流量。它现在有两点实际价值:
- 一份成本极低的站点自述。如果将来有人读,读到的是你自己的表述;
- 配套的 llms-full.txt 可以当现成的语料包,给自家 AI 功能或文档检索用。
写法上有个常见毛病:一堆裸链接,跟 sitemap 没区别,那不如不写。每个条目用一句大白话说清这个页面是干什么的、给谁看,把条数控制在几十行以内。铺整个 sitemap 进去就失去了“精选”的意义。
比这些文件更重要的东西
说了半天配置,真正决定 AI 能不能引用你的,是另外三件事:服务器直接返回的 HTML 里有没有实质内容(纯前端渲染、服务端返回空壳的页面,再完美的 robots.txt 也是给一扇门装了把好锁,屋里却是空的);内容里对实体和关系的表述是否清楚;有没有机器可读的、准确的站点与条目说明。
对目录站来说,第三点尤其有价值。你本来就在做结构化整理这件事,把条目描述、分类关系写清楚,比纠结拦不拦某个爬虫有用得多。