
robots.txt 里那些写了也不生效的规则:Crawl-delay、noindex 和几个常见错法
 r
我见过一份 robots.txt,站点主在文件里郑重其事地写了三行:一行禁止抓取某个目录,一行 noindex 同一个目录,一行 crawl-delay 设为 10。他的想法是三重保险。实际效果是:搜索引擎看不到目录内容,也看不到 noindex 指令,于是这个目录的 URL 靠外链还是进了索引,展示出来是一段没有描述的空白结果。
三行里有两行是废的,剩下那行还帮了倒忙。
图片来源:网络,版权归原作者所有,侵权请联系删除
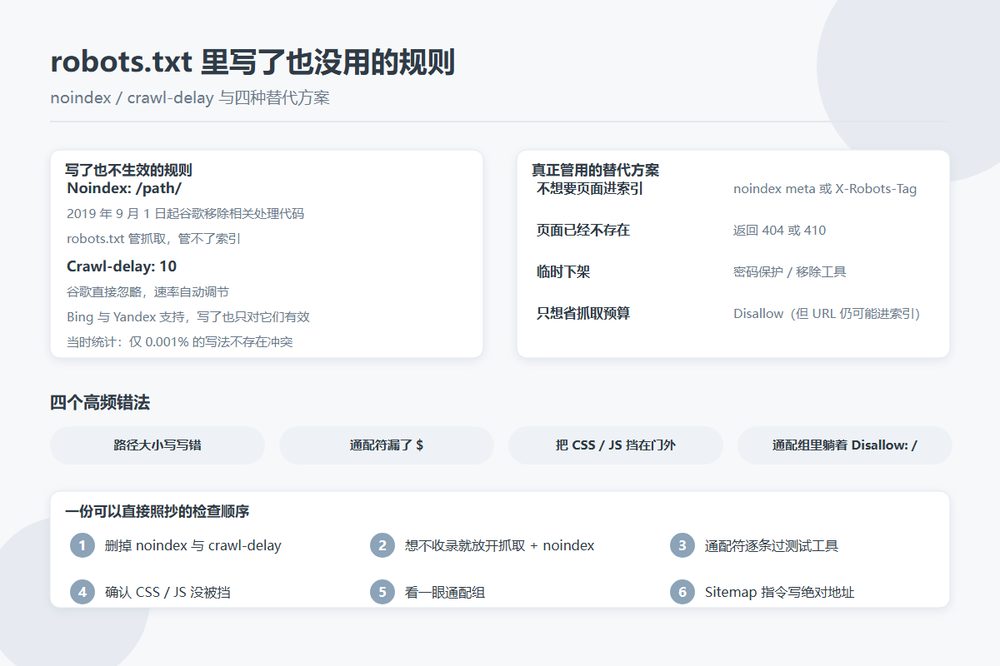
noindex 写在 robots.txt 里,早就不管用了
2019 年 7 月,谷歌在官方博客《A note on unsupported rules in robots.txt》里宣布:自 2019 年 9 月 1 日起,移除处理 robots.txt 中未公开支持规则(包括 noindex)的所有代码。
当时谷歌统计过,全互联网 robots.txt 文件中用到 crawl-delay、nofollow、noindex 这几条的,只有 0.001% 不存在与其他规则冲突的情况。也就是说,绝大多数这么写的站,写得都是错的,而且错得让站点在搜索结果里的表现变得更糟。
逻辑其实很好懂:robots.txt 管的是抓取,不是索引。你先用 Disallow 把爬虫挡在门外,它进不去,自然也就读不到你放在文件里的 noindex 指令。想让 noindex 生效,前提恰恰是允许抓取。
Crawl-delay 对谷歌同样无效
谷歌忽略 crawl-delay,抓取速率由系统自动调节。Bing 和 Yandex 是支持这条的,如果你的站主要面向这两个引擎,保留没问题;对谷歌来说,它就是一行注释。
真正管用的四种替代方案
| 目的 | 做法 | 注意点 |
|---|---|---|
| 不想要页面进索引 | 页面头部 noindex meta 标签,或 HTTP 响应头 X-Robots-Tag | 必须允许抓取,被 robots.txt 挡住的页面读不到这个标签 |
| 页面已经不存在 | 返回 404 或 410 状态码 | 410 表示永久移除,处理更快 |
| 临时下架 | 密码保护,或 Search Console 的移除工具 | 移除工具只是临时生效 |
| 只想省抓取预算 | Disallow | 有外链的 URL 仍可能被索引,只是没有内容摘要 |
最后一行是很多人踩的坑。以为 Disallow 了就等于从索引里消失了,结果 URL 因为外链还在结果里挂着,展示出来没标题没描述,比收录了还难看。真要清掉,就放开抓取、上 noindex,等处理完再考虑要不要 Disallow。
另外几个高频错法
路径大小写写错
规则里的路径是区分大小写的,/Admin/ 和 /admin/ 是两条不同的路径;指令名(User-agent、Disallow、Allow)则不区分大小写。目录站的 URL 里如果混用大小写,这里很容易漏。
通配符用了一半
* 匹配任意字符序列,$ 匹配结尾。没有 $ 时,规则匹配的是所有以该模式开头的 URL。想只拦 /search 而不拦 /search/result,必须写成 Disallow: /search$。只写一个前缀,会连同一大串正常页面一起挡掉。
把 CSS 和 JS 挡在门外
Disallow: /*.css$ 这种写法现在少了,但还有。搜索引擎需要渲染页面,你把样式和脚本挡了,它看到的是一个没有布局的页面,移动端友好性之类的判断会跟着出错。目录站尤其明显,因为页面结构本来就是靠 CSS 撑的。
忘了 User-agent: * 兜底
没有专门分组的爬虫会落到通配组。如果通配组里躺着一句 Disallow: /,那你后面给特定爬虫写的 Allow 全都不作数。改 robots.txt 之前先看一眼通配组,这个习惯能省很多事。
一份检查顺序
- 文件里有没有 noindex、nofollow、crawl-delay?有就删掉,改用对应方案;
- 有没有既 Disallow 又想不收录的路径?改成允许抓取 + noindex;
- 通配符规则有没有漏
$?逐条用测试工具验一遍; - CSS、JS、图片目录有没有被误挡?
- 通配组里有没有兜底的 Disallow: /?
- Sitemap 指令有没有写上,地址是不是绝对的?
robots.txt 是那种写一次就再也不看的文件,正因为如此,错在里面能错上好几年。每年巡检时花五分钟通读一遍,比出事之后排查划算得多。