
巡检、重建索引、发邮件:目录站那批后台任务该怎么排才不打架
 巡
目录站的后台任务有个共同特点:批量、耗时、对实时性没要求。巡检五千个站点是否存活、重建一次搜索索引、给订阅用户发一周新增邮件——这些都不需要毫秒级响应,但都很重。
图片来源:网络,版权归原作者所有,侵权请联系删除
先分清哪些是「任务」,哪些是「请求」
最容易出问题的设计是把批量动作塞进 Web 请求里。用户在后台点一下「重新抓取全部站点图标」,这个请求要跑四十分钟——网关先超时,然后用户重试,然后又跑一遍。
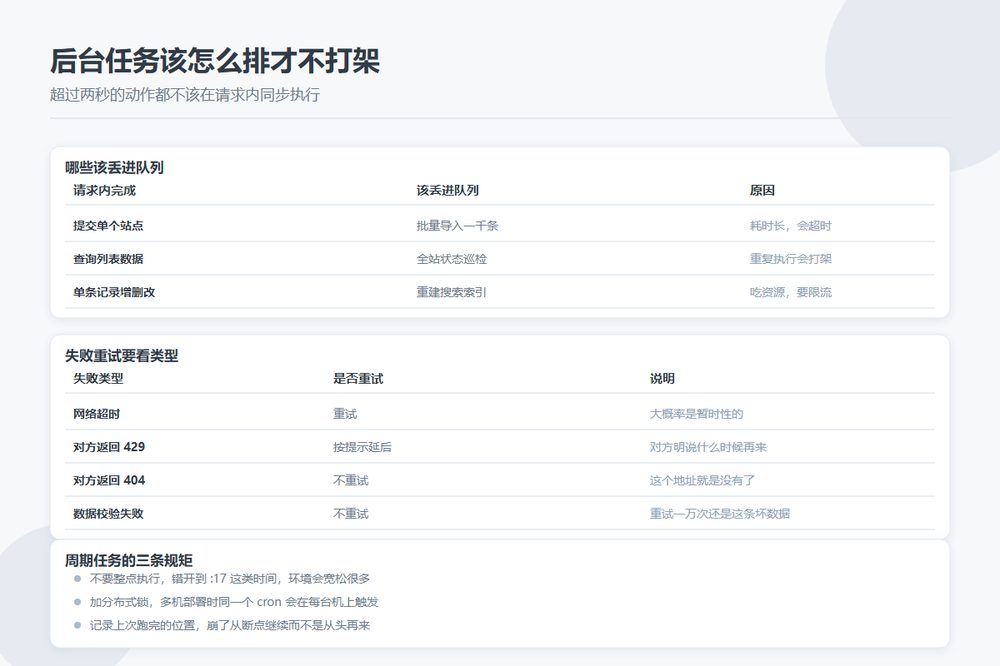
判断标准:超过两秒的动作都不应该在请求内同步执行。正确做法是请求只负责往队列里写一条任务,立刻返回,剩下的交给后台 worker。
| 应该在请求内完成 | 应该丢进队列 |
|---|---|
| 提交单个站点 | 批量导入一千条 |
| 查询列表数据 | 全站状态巡检 |
| 单条记录的增删改 | 重建搜索索引 |
| 发送一封验证邮件 | 给订阅者群发周报 |
右边这一列还有一个共同点:它们都需要可见的执行状态。用户发起之后要能看到「进行中,已完成 320/1000」,而不是干等着。所以队列任务必须带进度记录。
任务按资源消耗分层
所有任务都往同一个队列里塞,结果就是互相拖累。按消耗的主要资源分成三条 lane:
- CPU / 内存型——图片处理、索引重建、数据导出。特点是吃本地资源,worker 数量要受限。
- 网络型——外站巡检、推送通知、调第三方 API。特点是大多时间在等 IO,并发可以高,但要控制对外部的并发以免被当成攻击。
- 数据库型——批量更新、统计聚合。最容易把线上拖垮,必须限流。
三条 lane 各自有独立的并发上限。这样即使外站巡检开了两百个并发,也不会挤占索引重建需要的资源。
网络lane 的并发上限要按「对单个目标」而不是「总数」来设。巡检两百个不同站点没问题,同一个站点并发二十次就是攻击行了。
任务要幂等
幂等的意思是同一个任务执行两次,结果和执行一次一样。这听起来理所当然,实际很容易做错。
最常见的违反是计数类操作:UPDATE stats SET pv = pv + 1 执行一次和执行十次完全不同。遇到重试、重复入队、worker 崩溃后被重新调度,这类语句会把数据打乱。
三个让任务幂等的手段:
- 带唯一的任务键——同一个 uid 的任务只允许存在一个,重复写入会被去重
- 用覆盖写代替累加——把「加一」改成「按计算结果重新赋值」
- 执行前记录状态——任务表里有 running / done / failed 三态,重复调度时先看状态
第一条最省事。做法是在任务表上给业务键加唯一索引,写入时用 INSERT ... ON DUPLICATE KEY 或者直接忽略。巡检任务按「日期 + 站点 ID」去重,就不会出现同一天巡检了同一个站三次的情况。
失败重试的三个条件
不是所有失败都该重试。
| 失败类型 | 是否重试 | 说明 |
|---|---|---|
| 网络超时 | 重试 | 大概率是暂时性的 |
| 对方返回 429 | 按 Retry-After 延后 | 对方明确告诉你什么时候再来 |
| 对方返回 404 | 不重试 | 这个 URL 就是没有了 |
| 数据校验失败 | 不重试 | 重试一万次还是这条坏数据 |
| 本机资源不足 | 延后重试 | 等别的任务跑完 |
重试间隔必须是指数退避加随机抖动:1 分钟、5 分钟、25 分钟这样往上走,每档加一点随机时间。不做退避的话,一批任务同时失败同时重试,会形成周期性的洪峰。
重试次数上限设在三次到五次之间。超过之后移到「死信」列表,等着人工看。这个列表一定要有界面能看到,否则它等于黑洞——任务失败到这儿就没人再管了。
周期任务的三条规矩
- 不要整点执行。所有服务的定时任务都爱凑整点,你的巡检要是也赶在 :00,就会跟别人的任务一起挤在那几分钟。错开到 :17、:43 这类时间,环境会宽松很多。
- 加分布式锁。多机部署时,cron 在每个节点上都会触发。没有锁的结果就是同一个任务跑 N 遍。Redis 的 SET NX EX 是最常用的实现方式,锁超时时间要设得比任务最长执行时间更长。
- 记录上次跑完的位置。任务如果处理到一半崩了,下一次应该从断点继续而不是从头再来。给每个批次记一个游标,重启后从游标恢复。
留一条手动触发的通道
最后这件事务必做到:每个后台任务都要能在管理后台或命令行手动触发一次。
理由很简单,真出问题时你需要立刻重跑某个任务验证修好了没有,而不是等下一次定时。而且排查过程中手动单跑某一个条目的能力也很有用——把一万条批量拆成一次一条,能快速定位到底是哪条数据引发的崩溃。