
后台改完前台还是旧的:目录站读写分离之后必须处理的从库延迟
 后
把一个库拆成主库写、从库读,是目录站在数据量上来之后最常见的动作。收益明确:列表页、搜索、聚合统计这些重查询不再挤占写入资源。代价是数据一致性从「立刻」变成了「一会儿」。
图片来源:网络,版权归原作者所有,侵权请联系删除
延迟从哪来
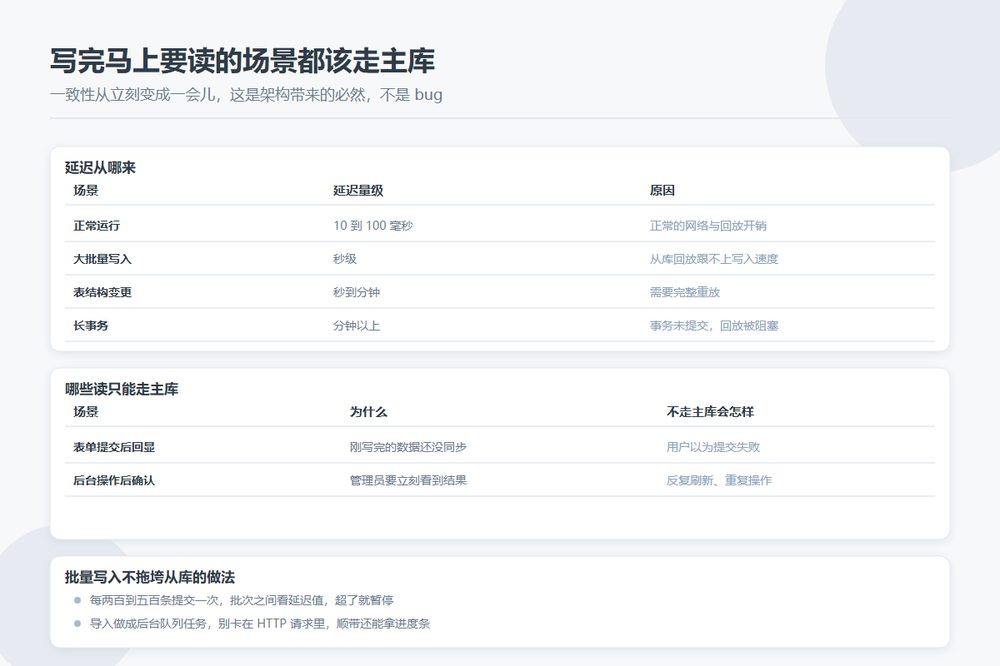
正常情况下主从延迟在几十毫秒量级,用户感知不到。出问题的时候往往是这几类:
| 场景 | 延迟量级 | 原因 |
|---|---|---|
| 正常运行 | 10-100 毫秒 | 正常的网络与回放开销 |
| 大批量写入 | 秒级 | 从库单线程回放跟不上 |
| 表结构变更 | 秒到分钟 | DDL 需要完整重放 |
| 从库负载过高 | 持续数秒 | 慢查询占了回放线程 |
| 长事务 | 分钟以上 | 事务未提交,回放被阻塞 |
对目录站来说最容易踩到的是第二种——批量导入几千条条目、或者跑一次全站状态刷新。这类操作一执行,从库延迟立刻爬到几秒,前台列表页上的数据在这几秒里全是旧的。
哪些读只能走主库
判断标准就一条:写完之后马上要读的场景。典型的几处:
- 表单提交后的回显——用户提交了新站点,跳转到的确认页必须能看到刚写入的数据,查从库查不到就是「提交失败」的观感
- 后台操作后的状态确认——审核通过一条,管理员看到的列表必须立刻更新
- 依赖写入结果的后续逻辑——拿到自增 ID 之后要读这条记录做下一步处理
- 对账类查询——统计准入库数量、校验导入结果这类场景,读从库会得到偏小的数字
不需要强一致的随便读从库:分类页、搜索结果、排行榜、详情展示。这些地方晚几百毫秒用户完全无感。
不要图省事把整个后台管理端都指向主库。后台里的统计报表、日志翻页这些重查询打到主库,等于把读写分离的好处又还回去了。按操作粒度判断,不要按入口判断。
批量写入怎么不拖垮从库
批量导入的场景,核心思路是把一次大事务拆成多次小事务。
- 每 200 到 500 条提交一次,中间留出让从库追上的空隙
- 两次批次之间 sleep 一小会儿,或者直接盯延迟值,超过阈值就暂停
- 导入任务本身做成后台队列,不要卡在 HTTP 请求里
第三点尤其重要。一次导入跑二十分钟,如果它是某个请求的一部分,那这个请求会遇到网关超时、连接断开、用户反复重试等一系列问题。做成异步任务,顺手还能拿到进度条。
前台怎么兜底
即使做了上面这些,偶尔还是会有用户看到旧数据。三条兜底:
- 写入成功后短暂标记——用户刚改过的数据在一小段时间内(比如 30 秒)强制走主库读,过了窗口再回到从库
- 编辑类操作给明确反馈——写完告诉用户「已提交,稍后生效」,把预期说出来,比让他反复刷新强
- 关键页面加版本号——详情页 URL 里带一个更新序号,改过之后序号变化,既能触发 CDN 更新,也方便回滚排查
第一条落地成本不高但收益明显。做法是在写入之后给当前会话打个时间戳标记,后续请求如果在这个窗口内,读操作走主库。窗口别设太长,否则等于退化回全主库。
监控要看三个数
光盯着「延迟多少秒」不够,还要看:
- 延迟的 p95 而不是平均值——平均值会被大量正常时段拉平,看不出问题
- 延迟超过阈值的持续时长——偶尔抖一下无所谓,连续五分钟高位就是事故
- 从库的回放线程状态——是卡在大事务上,还是在追赶 SQL_THREAD 的堆积
告警阈值别设太紧。延迟超过 3 秒且持续 2 分钟以上再告警,是多数业务能接受的配置。设成「超过 1 秒就报警」,告警会淹掉一切。
什么时候不用读写分离
条目数在十万以内、日访问量不高的时候,单库加索引加缓存通常就够了。读写分离引入的是一整套运维复杂度:延迟监控、路由规则、故障切换、从库挂了怎么办。
如果你现在的瓶颈是慢查询,先优化查询语句和索引;如果是连接数打满,先看看连接池配置。这两件事解决之后仍然扛不住,再考虑拆库。顺序反了,等于用架构复杂度去掩盖本来写得不好的 SQL。